
Praca z uczeniem maszynowym w Qlik Answers
Ostatnia aktualizacja: 2026-11-18Możesz pracować z Qlik Predict zautomatyzowanym uczeniem maszynowym, korzystając z technologii Qlik Answers opartej na sztucznej inteligencji.
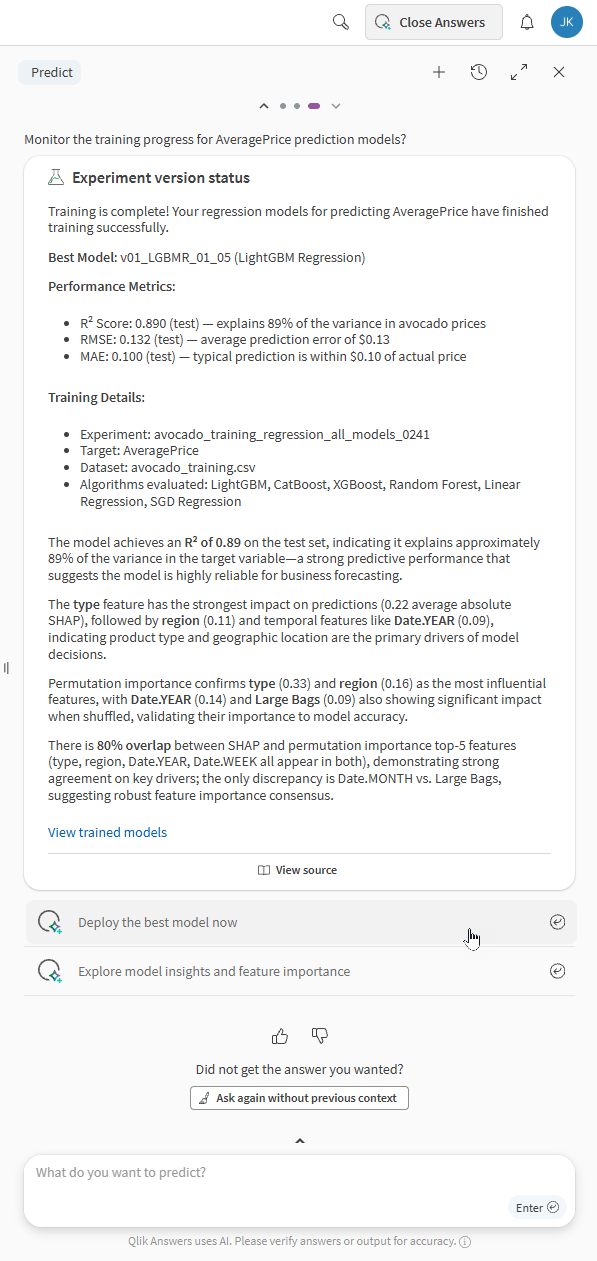
W środowisku agentowym Qlik Answers możesz tworzyć i uruchamiać przepływy pracy uczenia maszynowego w języku naturalnym. Możesz przeglądać zbiory danych, konfigurować i trenować eksperymenty oraz uruchamiać przewidywania z poziomu tego samego środowiska czatu.
To środowisko Qlik Answers jest oddzielne od uzyskiwania dostępu do możliwości Qlik Predict za pośrednictwem serwera MCP Qlik w zewnętrznym kliencie LLM. Aby uzyskać więcej informacji, zobacz temat Qlik serwer MCP.
Praca z Predict w Qlik Answers
Czynności wstępne
Wymagania wstępne:
-
Twoja dzierżawa ma włączone wnioskowanie międzyregionowe — to znaczy dzierżawa musi być włączona dla agentowego Qlik Answers środowiska.
-
Twoja dzierżawa i subskrypcja mają pojemność na Qlik Answers i Qlik Predict.
Monitorowanie wykorzystania pojemności Qlik Predict dla subskrypcji
-
Masz dostęp do wymaganych zbiorów danych i Qlik Predict zasobów.
Otwieranie Qlik Predict w Qlik Answers
Wykonaj następujące czynności:
-
Kliknij Otwórz Answers, aby otworzyć Qlik Answers.
-
W menu rozwijanym wybierz Predict.
Otwieranie Predict

Kompleksowe przepływy pracy
Podczas pracy z Predict korzystaj z poniższych przepływów pracy.
Krok 1: Eksploracja zbioru danych i wnioski
Użyj szczegółowych informacji o zestawie danych, aby zrozumieć jakość danych i pola kandydujące przed rozpoczęciem trenowania. Poproś o spostrzeżenia i rekomendacje dotyczące grupy docelowej.
Nie musisz również znać dokładnej nazwy zestawu danych, którego chcesz użyć — możesz poprosić o listę dostępnych zestawów danych.
| Działanie | Przykładowe pytania | Uwagi |
|---|---|---|
| Wybór zbioru danych |
|
- |
| Informacje o zestawie danych |
|
Alternatywnie możesz najpierw otworzyć zestaw danych w Qlik Cloud, a następnie zadać pytania, takie jak:
|
| Rekomendacja docelowa |
|
Przydatne jako pytania uzupełniające po wybraniu zestawu danych i przeanalizowaniu szczegółowych informacji. |
Krok 2: Trenowanie i monitorowanie eksperymentu
Opisz swój cel i pozwól agentowi skonfigurować oraz uruchomić eksperyment. Obsługiwane są typy eksperymentów regresji i klasyfikacji. Po wybraniu zbioru danych i celu zostanie wyświetlony monit o rozpoczęcie trenowania.
Jeśli wcześniej rozpoczęto już przepływ pracy uczenia maszynowego, możesz poprosić Predict o monitorowanie istniejących eksperymentów.
| Działanie | Przykładowe pytania | Uwagi |
|---|---|---|
| Trenowanie eksperymentu (z już wybranym zbiorem danych) |
|
Przydatne jako pytania uzupełniające po wybraniu zestawu danych treningowych do użycia. |
| Trenowanie eksperymentu (nie wybrano zestawu danych) |
|
Te pytania mogą pomóc Ci bezpośrednio rozpocząć pracę bez konieczności ręcznego wyszukiwania zbiorów danych według nazwy. |
| Monitorowanie eksperymentów |
|
- |
Krok 3: Interpretacja modelu i rekomendacje
Po zakończeniu trenowania możesz poprosić o interpretację zachowania modelu w przystępnym języku oraz rekomendacje oparte na wynikach modelu.
| Działanie | Przykładowe pytania | Uwagi |
|---|---|---|
| Rekomendacje modeli |
|
Aby uzyskać najlepsze wyniki, należy mieć otwarty eksperyment w przeglądarce lub odwołać się do nazwy eksperymentu w prompcie. |
| Wskaźniki modelu i spostrzeżenia |
|
Aby uzyskać najlepsze wyniki, należy mieć otwarty eksperyment w przeglądarce lub odwołać się do nazwy eksperymentu w prompcie. |
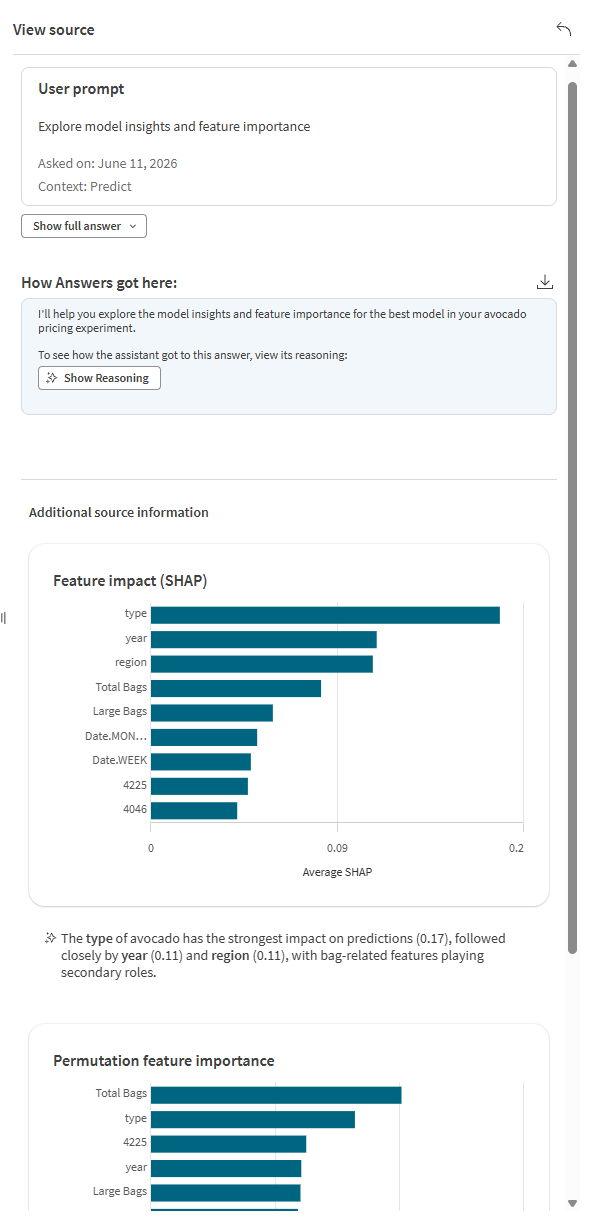
Podczas analizowania modeli na czacie możesz również kliknąć  Wyświetl źródło, aby rozwinąć dodatkowe szczegóły, w tym wykresy rozbicia ważności cech oraz wnioski w języku naturalnym.
Używanie opcji Wyświetl źródło do analizowania modeli z osadzonymi wykresami
Krok 4: Wdrożenie, aktywacja i predykcje
Po wytrenowaniu możesz wdrożyć model, tworząc wdrożenie ML. Gdy poprosisz, aby wdrożyć model, pojawi się monit o potwierdzenie wdrożenia.
Możesz także uruchamiać predykcje wsadowe przy użyciu wdrożonych modeli. System wyszukuje zgodne zbiory danych do zastosowania i wyświetla ich listę do wyboru. Możesz także użyć poleceń w języku naturalnym, aby wybrać określony zbiór danych do zastosowania.
Wdrożone modele są aktywowane automatycznie w miarę tworzenia predykcji, w zależności od dostępnej pojemności dla subskrypcji.
| Działanie | Przykładowe pytania | Uwagi |
|---|---|---|
| Wdrożenie i monitorowanie modelu |
|
Przydatne jako pytania uzupełniające bezpośrednio po analizie modelu. Aby uzyskać najlepsze wyniki, należy mieć otwarty eksperyment w przeglądarce lub odwołać się do nazwy eksperymentu w prompcie. |
| Predykcje — rozpoczęcie żądania |
|
Aby uzyskać najlepsze rezultaty, musisz mieć otwarte wdrożenie w przeglądarce lub odwołać się do nazwy wdrożenia w monicie. |
| Predykcje — wybór zbioru danych do zastosowania |
|
Aby uzyskać najlepsze rezultaty, musisz mieć otwarte wdrożenie w przeglądarce lub odwołać się do nazwy wdrożenia w monicie. |
| Prognozy — stan monitora |
|
Aby uzyskać najlepsze rezultaty, musisz mieć otwarte wdrożenie w przeglądarce lub odwołać się do nazwy wdrożenia w monicie. |
| Predykcje — eksploruj wyniki predykcji |
|
Aby uzyskać najlepsze rezultaty, musisz mieć otwarte wdrożenie w przeglądarce lub odwołać się do nazwy wdrożenia w monicie. |
Dobre praktyki dotyczące zadawania pytań
Aby uzyskać najlepsze rezultaty podczas pracy z Qlik Predict w Qlik Answers, należy obserwować te ogólne wytyczne:
-
Jeśli nie masz pewności, jak zacząć, zapytaj Predict, co potrafi. Qlik Answers może udostępnić listę obsługiwanych możliwości.
-
Rozpocznij nową konwersację przy zmianie tematu lub jeśli nie otrzymujesz potrzebnej odpowiedzi.
-
Jeśli nie otrzymujesz wymaganej odpowiedzi, spróbuj podać więcej szczegółów i precyzyjnie określ, co chcesz zrobić. Na przykład odwoływanie się do dokładnych nazw zbiorów danych i innych zasobów może pomóc Qlik Answers lepiej je znaleźć podczas rozpoczynania trenowania lub uruchamiania predykcji.
-
Przeformułuj pytanie, jeśli za pierwszym razem nie zwróci ono odpowiedzi, której potrzebujesz.
Aby uzyskać więcej informacji, zobacz temat Najlepsze praktyki czatowania z Qlik Answers.
Uprawnienia
Potrzebujesz zarówno uprawnień Qlik Answers, jak i Qlik Predict, aby realizować kompleksowe przepływy pracy uczenia maszynowego.
Potrzebne są poniższe pozycje:
-
Uprawnienie użytkownika profesjonalnego (dotyczy tylko subskrypcji opartych na użytkownikach)
-
Wymagane uprawnienie Agentic AI > Analiza danych ustawione na Dozwolone. To uprawnienie przyznaje administrator dzierżawy.
-
Wymagane uprawnienia Qlik Predict do pracy z eksperymentami i wdrożeniami ML, przypisane Ci przez administratora dzierżawy. Zob.:
-
Dostęp do przestrzeni, w których znajdują się zbiory danych, eksperymenty i wdrożenia. Zob.:
Ograniczenia
Zestawy danych
Aktualizowanie i usuwanie zestawów danych
Nie możesz przesyłać ani usuwać zestawów danych z poziomu czatu.
Zmiana zestawów danych
Następujące czynności nie są możliwe na czacie:
-
Zmiana zbiorów danych treningowych po uruchomieniu wersji eksperymentu.
-
Uruchamianie wielu predykcji z różnymi zbiorami danych do zastosowania w ramach tego samego czatu.
Jako obejście problemu, gdy musisz trenować eksperymenty lub uruchamiać predykcje przy użyciu innego zestawu danych, najpierw rozpocznij nowy czat. Jeśli trenujesz eksperymenty, będzie to również wymagało utworzenia nowego eksperymentu w nowym czacie.
Aby uzyskać więcej informacji na temat rozpoczynania nowych czatów, zobacz temat Czatowanie z Qlik Answers.
Duże zestawy danych
Czat nie obsługuje zestawów danych, które przekraczają którykolwiek z następujących limitów dla dzierżawy Qlik Cloud:
-
Maksymalny rozmiar zestawu danych (treningowe zestawy danych)
-
Maksymalna liczba komórek zestawu danych (treningowe zestawy danych)
-
Maksymalna liczba uwzględnionych kolumn (zbiory danych treningowych i do zastosowania)
Funkcje eksperymentu
-
Wykrywanie stronniczości nie jest obsługiwane.
-
Nie można analizować ani pobierać raportów z trenowania modeli.
-
Nie można uzyskać dostępu do wbudowanej analityki (kart Porównaj i Analizuj) dla tego eksperymentu.
-
Wszystkie cechy i algorytmy są wybierane do trenowania podczas konfigurowania eksperymentu. Nie można odznaczyć cech ani algorytmów. Ponadto do trenowania modeli zawsze stosowana jest inteligentna optymalizacja modeli — ręczna optymalizacja nie jest obsługiwana.
-
Nie można trenować drugiej i kolejnych wersji eksperymentu.
Typy modeli
Niedostępne dla modeli szeregów czasowych.
Typy predykcji
Niedostępne dla prognoz w czasie rzeczywistym lub opartych na łącznikach.
Zarządzanie modelem uczenia maszynowego
-
Nie można zastąpić istniejącego wdrożonego modelu z poziomu czatu.
-
Nie można wdrożyć wielu modeli z różnych wersji eksperymentu z poziomu czatu.
-
Dostęp do wbudowanej analityki (operacje na modelach i monitorowanie dryfu) dla wdrożenia nie jest możliwy.