
Experimenten configureren
Laatst bijgewerkt: 2026-11-03De configuratie van experimenten bestaat uit het selecteren van het doel en de functies die het model zal gebruiken om het doel te voorspellen. U kunt tevens een aantal optionele instellingen configureren.
Om u te helpen bij de selectie van een doel, wordt de historische gegevensverzameling geanalyseerd en wordt een samenvatting van de statistieken weergegeven voor iedere kolom in de gegevensverzameling. Er worden verschillende automatische voorbewerkingsstappen op de gegevensverzameling toegepast om er zeker van te zijn dat er alleen geschikte gegevens worden toegevoegd. Voor meer informatie over de voorbewerking van gegevens, kunt u Geautomatiseerde voorbereiding en transformatie raadplegen.
Na het uitvoeren van v1 kunt u indien nodig nieuwe experimentversies maken om de modeltraining verder te verfijnen. Ga voor meer informatie naar Modellen verfijnen.
Vereisten en machtigingen
Raadpleeg Werken met experimenten voor meer informatie over de gebruikersvereisten voor het werken met ML-implementaties.
De interface
De volgende sectie toont hoe u door de experimentinterface kunt navigeren om uw experiment te configureren. Zie Navigeren in de experimentinterface voor meer informatie over de interface
Tabbladnavigatie
When u een experiment maakt, opent het tabblad Configuratie. Hier kunt u het doel en de functies voor het experiment configureren.
Na het uitvoeren van ten minste één experimentversie verandert het tabblad Configuratie in Trainingsgegevens. Andere tabbladen worden ook beschikbaar. Met deze andere tabbladen kunt u de modellen analyseren die u binnen de versie hebt getraind. U kunt terugkeren naar het tabblad Trainingsgegevens als u opeenvolgende versies met verschillende functieselecties moet configureren.
Schemaweergave en Gegevensweergave
Op het tabblad Configuratie/Trainingsgegevens kunt u schakelen tussen  Schemaweergave en
 Gegevensweergave.
Schemaweergave
Schemaweergave is de standaardweergave. In deze weergave wordt iedere kolom in uw gegevensverzameling vertegenwoordigd door een rij in het schema met informatie en statistieken.
U kunt:
-
Selecteer functies om op te nemen in uw experiment.
-
Bekijk details over elke kolom, zoals gegevenstype en functietype.
-
Bekijk inzichten over kolommen, zoals waarom ze niet kunnen worden geselecteerd, of hoe ze tijdens de training worden verwerkt.
 om de informatie in de tabel aan te passen. U kunt bijvoorbeeld bepaalde kolommen verbergen om de weergegeven informatie te beperken.
Schemaweergave in een ML-experiment

Gegevensweergave
Gegevensweergave is een alternatieve weergave die u kunt gebruiken om toegang te krijgen tot meer informatie en voorbeeldgegevens voor elke kolom.
Gegevensweergave in een ML-experiment

Deelvenster Experimentconfiguratie
In het experimentconfiguratiepaneel kunt u de training van het experiment verder aanpassen. Dit paneel is standaard geopend in nieuwe experimenten.
Klik na het uitvoeren van een versie op  Configuratie weergeven om het paneel te openen om de volgende versie te configureren.
Met het venster Experimentconfiguratie kunt u het volgende doen:
-
Selecteer een doel en experimenttype
-
Stel een versienaam in
-
Functies toevoegen of verwijderen
-
Configureer een nieuwe versie van het experiment
-
Bekijk het type model dat u traint
-
Selecteer om de trainingsgegevensset te wijzigen of te vernieuwen
-
Algoritmen toevoegen of verwijderen
-
Instellingen voor modeloptimalisatie wijzigen
-
Stel voor tijdreeksmodellen de prognose-instellingen in
-
Configureer biasdetectie
Configuratiepaneel voor experimenten

Selecteer het doel en experimenttype
U kunt de doelkolom en het experimenttype wijzigen tot u de eerste training start. Hierna wordt ze vergrendeld tegen bewerken.
De doelkolom bevat de waarden waarvan u wilt dat het machine learning-model ze voorspelt.
Het experimenttype wordt bepaald door het doel en het type gegevens dat het bevat. Het experimenttype definieert welk type model u wilt trainen. De volgende opties zijn mogelijk beschikbaar:
-
Binaire classificatie: traint modellen om een doel te voorspellen dat twee mogelijke waarden heeft (bijvoorbeeld ja of nee). Gegevens kunnen van elk functietype zijn.
-
Multiclass-classificatie: traint modellen om een doel te voorspellen met 3-10 mogelijke waarden (bijvoorbeeld een lijst met categorieën). Gegevens kunnen van elk functietype zijn, maar een kolom met meer dan 10 unieke, niet-numerieke klassen (waarden) kan niet als doel worden geselecteerd.
-
Regressie: traint modellen om een doel te voorspellen met meer dan 10 mogelijke waarden — specifiek, een doel met een numeriek functietype.
-
Tijdreeks: traint modellen om doelwaarden te voorspellen voor specifieke toekomstige tijdsperioden, gebruikmakend van historische gegevens. Het doel moet meer dan 10 afzonderlijke waarden hebben en numerieke gegevens bevatten. Ga voor meer informatie naar Werken met tijdreeksexperimenten.
Doe het volgende:
-
In
Schemaweergave of Gegevensweergave klikt u op het keuzerondje voor een kolom.De doelkolom wordt nu aangeduid door
 en de overige beschikbare kolommen worden automatisch als functies geselecteerd.
Het doel selecteren in Schemaweergave

In het experimentconfiguratiepaneel kunt u onder Experimentinstellingen indien nodig vóór de training het doel wijzigen.
Als er een datumfunctie in de dataset aanwezig is en het doelfunctietype numeriek is, kunt u schakelen tussen Multiklasseclassificatie en Binaire classificatie.
Als tijdreeksvoorspelling mogelijk is voor uw gegevensverzameling en doel, kunt u het experimenttype wijzigen van Regressie naar Tijdreeks.
Experimentinstellingen kan een selector voor Experimenttype bevatten. Bijvoorbeeld:
Wanneer het doel en experimenttype zijn geselecteerd, kunt u de eerste versie van het experiment uitvoeren. Lees meer in Trainingsexperimenten. U kunt nu meer opties configureren (zoals hieronder beschreven) of de configuratie aanpassen nadat u de trainingsresultaten hebt bekeken.
Tijdens de experimenttraining wordt er uitleg getoond over hoe uw gegevens worden geïnterpreteerd en verwerkt. Ga voor meer informatie naar Inzichten over gegevensverzamelingen interpreteren.
Kenmerkkolommen selecteren
Met de doelset kunt u kiezen welke van de overige beschikbare kolommen u aan de training van het model wilt toevoegen. Sluit functies uit die geen onderdeel van het model moeten zijn. Deze kolom blijft in de gegevensverzameling staan, maar wordt niet gebruikt voor de training van het algoritme.
Bovenaan in het paneel Experimentconfiguratie ziet u het aantal cellen in uw gegevensverzameling. Als het aantal de limiet van uw gegevensverzameling overschrijdt, kunt u kenmerken uitsluiten om onder de limiet te blijven.
U kunt de kenmerkkolommen op verschillende manieren selecteren:
In Schemaweergave en Gegevensweergave
In de algemene weergaven kunt u het volgende doen:
-
Hef de selectie van Alle kenmerken opnemen op en selecteer vervolgens alleen de kenmerken die u wilt gebruiken.
-
U kunt de selectievakjes voor de kenmerken die u niet wilt toevoegen, handmatig uitschakelen.
-
Voer een zoekopdracht uit en sluit alle kenmerken in uw gefilterde zoekresultaat uit of voeg ze toe.
In deze weergaven staat naast elke kolom een pictogram om meer informatie te geven:
-
 : De functie is opgenomen, of kan worden opgenomen, in het experiment.
-
 : De functie is uitgesloten van het experiment. Het kan soms worden opgenomen, maar dit wordt over het algemeen niet aanbevolen.
-
 : De functie kan niet worden opgenomen in het experiment.
In het venster voor experimentconfiguratie
In het venster Experimentconfiguratie kunt u het volgende doen:
-
U kunt de selectievakjes voor de kenmerken die u niet wilt toevoegen, handmatig uitschakelen.
-
Nadat u de eerste versie van het experiment hebt uitgevoerd, kunt u het Aantal topkenmerken die opgenomen moeten worden definiëren.
Sectie Functies in het deelvenster voor experimentconfiguratie
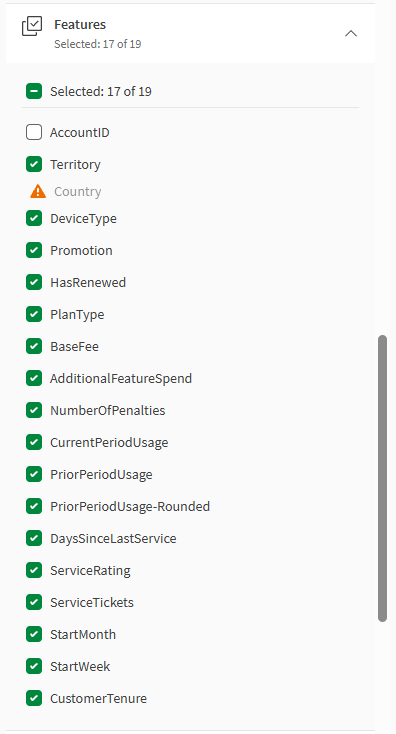
Als u kenmerken selecteert, wordt hieraan automatisch een kenmerktype toegewezen. De mogelijke functietypen zijn:
-
Categorisch
-
Numeriek
-
Datum
-
Vrije tekst
Het functietype is gebaseerd op de gegevens in de functiekolom. Als een functie aan bepaalde criteria voldoet, kan deze worden geselecteerd om de basis te vormen voor automatisch ontwikkelende functies. Indien gewenst kunt u wijzigen of de functie voor automatische functieontwikkeling wordt gebruikt. Voor meer informatie over automatische functieontwikkeling gaat u naar Automatische functieontwikkeling.
Bepaalde kolommen in uw gegevensverzameling kunnen mogelijk niet worden geselecteerd als kenmerken voor uw experiment. Er kan ook een specifieke bewerking op worden toegepast. Wanneer u door de experimenttraining navigeert, wordt er uitleg getoond over hoe uw gegevens worden geïnterpreteerd en verwerkt. Ga voor meer informatie naar Inzichten over gegevensverzamelingen interpreteren.
Biasdetectie configureren
U kunt biasdetectie activeren voor functies die gevoelige gegevens bevatten. Biasdetectie wordt uitgevoerd wanneer u het experiment uitvoert. U kunt ook klikken op Aanbevelingen ophalen om generatieve AI te gebruiken om uw trainingsgegevens te scannen op mogelijk gevoelige functies voordat u biasdetectie uitvoert.
Biasdetectie bepaalt of de functie de waarschijnlijkheid van het model vergroot om oneerlijke uitkomsten in zijn voorspellingen te bevorderen, of dat de brongegevens inherent bevooroordeeld zijn.
Doe het volgende:
-
Vouw in een ML-experiment Bias uit in het configuratiepaneel voor training.
-
Voordat u functies selecteert voor biasdetectie, klikt u optioneel op Aanbevelingen ophalen om generatieve AI te gebruiken om functies voor te stellen die bevooroordeelde gegevens kunnen bevatten. Zie: Generatieve AI gebruiken om functies aan te bevelen voor biasdetectie.
-
Selecteer of deselecteer functies waarvoor u biasdetectie wilt uitvoeren.
Als alternatief schakelt u biasdetectie in voor de gewenste functies in Schemweergave.
Voor meer informatie over biasdetectie, zie Bias detecteren in machine learning-modellen.
Algoritmen selecteren
Standaard worden alle beschikbare algoritmen toegevoegd. Algoritmen die u niet wilt gebruiken, kunt u uitsluiten. U zou dit normaliter doen als onderdeel van modelverfijning wanneer u de eerste trainingsresultaten hebt gezien. Lees meer in Modellen verfijnen.
Sectie Algoritmen in het venster voor experimentconfiguratie

Kenmerktypen wijzigen
Wanneer een gegevensverzameling wordt geladen, worden de kolommen op basis van het gegevenstype behandeld als categorisch, numeriek of datum. Het kan voorkomen dat u deze instelling wilt wijzigen.
Als bijvoorbeeld de dagen van de week worden vertegenwoordigd door de getallen 1 t/m 7, dan vertegenwoordigt ieder getal een categorische waarde. Dit wordt standaard behandeld als een doorlopend gerangschikte numerieke waarde. Daarom dient u de configuratie handmatig te wijzigen om de waarde te behandelen als categorisch.
Als wordt vastgesteld dat een kolom datum- en tijdinformatie bevat, wordt de kolom gebruikt als de basis voor het genereren van nieuwe automatisch ontworpen kenmerken. Als dit gebeurt, wordt de oorspronkelijke kolom (de bovenliggende functie) behandeld als een kolom van het functietype datum.
U kunt de bovenliggende functie wijzigen van een datumfunctie naar een categorische of numerieke functie. Dit is bijvoorbeeld handig wanneer een functie wordt geïdentificeerd als een datum, maar u wilt dat deze als een tekenreeks of getal wordt behandeld. Als u dit doet, kunt u de automatisch ontwikkelde functies niet meer in de experimenttraining gebruiken.
Doe het volgende:
-
In
Schemaweergave zoekt u de functie. -
Klik in de kolom Kenmerktype van dit kenmerk op
 .
-
Selecteer een waarde in de lijst.
Vanuit Gegevensweergave kunt u desgewenst functietypen wijzigen. Zoek de functie, klik vervolgens op naast het huidige functietype. Selecteer een waarde in de lijst.
Prognoses van tijdreeksen
Als u een tijdreeksexperiment traint, worden bepaalde functietype transformaties automatisch toegepast, afhankelijk van uw configuratie. Als u bijvoorbeeld groepen selecteert om te gebruiken voor multivariate voorspelling, worden de functietypen van deze groepen automatisch omgezet naar categorisch.
Invloed op voorspellingen
Wanneer u handmatig het functietype van een functie wijzigt en vervolgens een resulterend model implementeert, worden de functietype-overschrijvingen toegepast op de functie in de toepasbare gegevensverzameling die wordt gebruikt in voorspellingen die met dat model zijn gemaakt.
Gegevensverzameling wijzigen
U kunt de trainingsgegevensset wijzigen voordat u de eerste experimentversie uitvoert. U kunt dit ook doen na het uitvoeren van een versie.
Als u de gegegevensverzameling wijzigt nadat u de eerste versie hebt uitgevoerd, verliest u configuraties die u hebt gemaakt voordat u de gegevensverzameling wijzigde.
Doe het volgende:
-
Klik in het configuratiedeelvenster van het experiment onder Trainingsgegevens > Dataset controleren op Dataset wijzigen.
-
Selecteer een nieuwe gegevensverzameling.
Zie De gegevensverzameling wijzigen en vernieuwen voor meer informatie over het wijzigigen en vernieuwen van de gegevensverzameling tijdens het verfijnen van het model (na de uitvoering van een experimentversie).
Modeloptimalisatie configureren
Als uw experimenttype binaire classificatie, multiclass-classificatie of regressie is, kunt u de volgende instellingen aanpassen om uw modellen te optimaliseren:
-
Intelligente modeloptimalisatie in- of uitschakelen
-
Hyperparameteroptimalisatie in- of uitschakelen
-
Tijdbewuste training in- of uitschakelen
Deze opties kunnen in- of uitgeschakeld worden voor elke versie van het experiment dat u uitvoert.
Sectie Modeloptimalisatie in het experimentconfiguratiepaneel
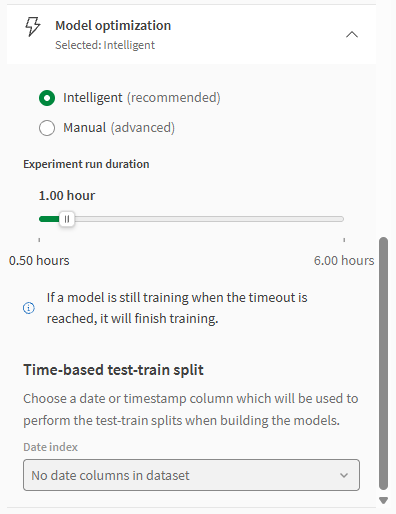
Intelligente optimalisatie configureren
Het experiment wordt standaard uitgevoerd met intelligente modeloptimalisatie. Met intelligente modeloptimalisatie voert Qlik Predict het modelverfijningsproces voor u uit door functieselectie te herhalen en geavanceerde transformaties toe te passen op uw gegevens.
Zie Intelligente modeloptimalisatie voor meer informatie over intelligente optimalisatie.
U kunt deze instelling uitschakelen om handmatig de modellen die u traint te verfijnen. U wilt bijvoorbeeld uw modeltraining starten met intelligente modeloptimalisatie en vervolgens overschakelen naar handmatig verfijnen voor v2 om de configuratie verder aan te passen.
Doe het volgende:
-
Klik op
Configuratie weergeven. -
Klik op Nieuwe versie als u al ten minste één versie van het experiment hebt uitgevoerd.
-
In het venster vouwt u Modeloptimalisatie uit.
-
Schakel over van Intelligent naar Handmatig.
-
Stel met de schuifregelaar de maximum uitvoeringsduur van de training in.
Optimalisatie van hyperparameter configureren
U kunt de modellen optimaliseren met behulp van optimalisatie van de hyperparameter. Dit is een geavanceerde optie die de duur van de training aanzienlijk kan verhogen. Hyperparameter-optimalisatie is beschikbaar als u intelligente optimalisatie hebt uitgeschakeld.
Ga voor meer informatie naar Hyperparameteroptimalisatie.
Doe het volgende:
-
Klik op
Configuratie weergeven. -
Klik op Nieuwe versie als u al ten minste één versie van het experiment hebt uitgevoerd.
-
In het venster vouwt u Modeloptimalisatie uit.
-
Schakel over van Intelligent naar Handmatig.
-
Selecteer het selectievakje Hyperparameteroptimalisatie.
-
U kunt desgewenst een tijdslimiet voor uw optimalisatie instellen. De standaardtijdslimiet is één uur.
Tijdbewuste training configureren
Als u wilt dat uw modellen worden getraind door rekening te houden met een dimensie van tijdreeksen, activeer dan tijdbewuste training voor de experimentversie. Om deze optie te gebruiken, moet u een kolom in uw gegevensverzameling hebben die de relevante tijdreeksinformatie bevat.
Als Tijdbewuste training is ingeschakeld, gebruikt Qlik Predict gespecialiseerde kruisvalidatie- en null-imputatieprocessen om de modellen te trainen.
Ga voor meer informatie naar Tijdbewuste modellen maken en Tijdgebaseerde kruisvalidatie.
Doe het volgende:
-
Klik op
Configuratie weergeven. -
Klik op Nieuwe versie als u al ten minste één versie van het experiment hebt uitgevoerd.
-
In het venster vouwt u Modeloptimalisatie uit.
-
Selecteer onder Tijdgebaseerde splitsing test-training de Datumindexatie die u wilt gebruiken voor het sorteren van de gegevens.
Inzichten over de trainingsgegevens weergeven
Op het tabblad Configuratie/Trainingsgegevens van het experiment kunt u inzichten bekijken in de verwerking van de trainingsgegevens. Deze informatie is beschikbaar in zowel Schemaweergave als Gegevensweergave. De informatie die wordt getoond is afhankelijk van het feit of u wel of niet een versie met de huidige trainingsgegevens hebt uitgevoerd. De wijzigingen in de Inzichten kunnen u helpen om te identificeren waarom functies mogelijk niet beschikbaar zijn om te gebruiken of waarom ze automatisch zijn verwijderd.
Raadpleeg Inzichten over gegevensverzamelingen interpreteren voor meer informatie over de betekenis van elk inzicht.