
レプリケーションの設定
最終更新日時: 2026/10/09データ レプリケーション タスクの設定を構成できます。
-
レプリケーション タスクを開き、ツール バーの [設定] をクリックします。
「設定: <タスク名>」ダイアログが開きます。使用可能な設定については以下で説明します。
基本設定
このタブでは、レプリケーション モード、ステージング設定 (使用可能な場合)、ターゲットへの変更適用モード、公開設定を変更できます。
レプリケーション モード
次のレプリケーション モードを使用できます。
-
フル ロード: 選択したソース テーブルからターゲット プラットフォームにデータをロードし、必要に応じてターゲット テーブルを作成します。フル ロードはタスクの開始時に自動的に実行されますが、必要に応じて手動で実行することもできます。たとえば、ビューへの更新 (CDC 中にキャプチャされない) をレプリケートする必要がある場合や、CDC をサポートしていないデータ ソースからレプリケートする場合は、手動によるフル ロードが必要になります。
情報メモSaaS アプリケーション コネクタを使用する場合、フル ロードが必要なため、このオプションは常に有効になります。 -
変更を適用: ソース テーブルに加えられた変更を反映して、ターゲット テーブルを最新の状態に保ちます。
-
保存先の変更: ソース テーブルへの変更を変更テーブル (ソース テーブルごとに 1 つ) に保存します。
詳細については、「変更の保存」を参照してください。
Data Movement gateway を使用する場合、SaaS アプリケーションをソースとする場合を除き、ソースからの変更はほぼリアルタイムでキャプチャされます。Data Movement gateway を使用せずに作業する場合 (例: Qlik Talend Cloud スターター サブスクリプションを使用する場合、または [なし] を選択した場合 )、または SaaS アプリケーションをソースとして使用する場合は、変更はスケジューラーの設定に従ってキャプチャされます。詳細については、「Scheduling tasks」を参照してください。
[変更の保存] または [変更の適用] を選択し、データ ソースが次の場合:
-
SaaS アプリケーションではない
-
CDC をサポートするデータセットと、フル ロードのみをサポートするデータセット (ビューなど) が含まれている
2 つのデータ パイプラインが作成されます。CDC をサポートするテーブル用に 1 つのパイプラインが作成され、フル ロードのみをサポートするデータセット用にもう 1 つのパイプラインが作成されます。
ロード方法
Snowflake にレプリケートする場合は、次のいずれかのロード方法を選択できます。
-
一括ロード (既定)
[一括ロード] を選択した場合、 [データのアップロード] タブでロード パラメーターを調整できるようになります。
-
Snowpipe Streaming
情報メモSnowpipe Streaming は、次の条件が満たされている場合にのみ選択できます。
- [変更の適用] なしで、 [変更の保存] レプリケーション モードが有効になっています。
- Snowflake コネクタの [認証メカニズム] は [キー ペア] に設定されています。
- Data Movement gateway を使用する場合は、バージョン 2024.11.45 以降が必要です。
Snowpipe Streaming を選択する場合は、この方法を使用する際の制限事項と考慮事項をよく理解しておく必要があります。さらに、Snowpipe Streaming を選択し、 [変更の適用] レプリケーション モードを有効にするか、 [変更の保存] を無効にすると、ロード方法は自動的に [一括ロード] に戻ります。
[一括ロード] ではなく、Snowpipe Streaming を選択する主な理由は次のとおりです。
-
コストの削減: Snowpipe Streaming は Snowflake ウェアハウスを使用しないため、運用コストは大幅に安くなると考えられますが、これは具体的なユース ケースに応じて異なります。
-
レイテンシの低減: データがステージングを経由せずに直接ターゲットテーブルにストリーミングされるため、データソースからターゲットへのレプリケーションがより高速になると考えられます。
ステージング エリアへの接続
以下にリストされているデータ ウェアハウスにレプリケーションする場合は、ステージング エリアを設定する必要があります。データは、ウェアハウスに転送される前にステージング エリアで処理および準備されます。
既存のステージング エリアを選択するか、[新規作成] をクリックして新しいステージング エリアを定義し、クラウド ストレージへの接続 の指示に従います。
接続設定を編集するには、[編集] をクリックします。接続をテストするには (推奨)、[接続のテスト] をクリックします。
どのステージング エリアがどのデータ ウェアハウスでサポートされているかについては、ターゲット プラットフォームのユース ケースとサポートされるバージョン の [ステージング エリアとしてサポート] 列を参照してください。
変更適用モード
変更は、次のいずれかの方法でターゲット テーブルに適用されます。
- バッチ最適化: これが既定です。このオプションを選択すると、変更はバッチで適用されます。トランザクションをもっとも効率的な方法でバッチにグループ化するための前処理アクションが発生します。
- トランザクション: このオプションを選択すると、各トランザクションをコミットされた順序で個別に適用します。この場合、すべてのテーブルで厳密な参照整合性が確保されます。
公開設定
-
カタログに公開する
このオプションを選択して、データのこのバージョンをデータセットとしてカタログに公開します。カタログのコンテンツは、このタスクを次回準備する際に更新されます。
カタログの詳細については、カタログ ツールの使用によるデータの理解 を参照してください。
Data Movement gateway 使用時のプロキシ設定
-
Data Movement gateway を使用する場合は、プロキシ経由で接続します
Data Movement gateway を使用すると、プロキシを介してターゲット プラットフォームとステージング プラットフォーム (領域) に接続できます。
Data Movement gateway でプロキシ サーバーを使用するための設定の詳細については、「Qlik Cloud テナントとプロキシ サーバーの設定」を参照してください。
-
データ移動ゲートウェイの使用時はプロキシ サーバー
Data Movement gateway に設定されたプロキシ サーバーを使用するには、このオプションを選択します。
-
ターゲット プラットフォーム
情報メモSnowflake および Databricks 使用時に利用できます。 -
ステージング プラットフォーム
情報メモGoogle BigQuery、Amazon Redshift、Microsoft Fabric、Databricks 使用時に利用できます。
-
データのアップロード
このタブは、データ ウェアハウスまたは Kafka ターゲットにレプリケートする場合にのみ表示されます。また、このタブの設定は選択したターゲットに応じて異なります。
すべてのデータ ウェアハウス ターゲットに関連
最大ファイル サイズ
ファイルが閉じる前に到達できる最大サイズ。並列実行オプションと併用すると、小さいファイルの方がアップロードが速くなり (ネットワークに応じて異なる)、パフォーマンスが向上する可能性があります。ただし、小さなファイルでデータベースを乱雑にすることは一般的に悪い習慣であると考えられています。
Snowflake ターゲットにのみ関連
[一般] タブでは、 [一括ロード] または Snowpipe Streaming を使用してデータを Snowflake にロードするかどうかを選択できます。Snowpipe Streaming を選択すると、 [データのアップロード] タブは表示されません。[一括ロード] を選択すると、次の設定を使用できます。
-
最大ファイル サイズ (MB): 最初のフル ロードおよび CDC に関連します。ファイルがターゲットにロードされる前に到達できる最大サイズ。パフォーマンスの問題が発生した場合は、このパラメーターを調整してください。
-
バッチでロードするファイルの数: 最初のフル ロードにのみ関連します。1 回のバッチでロードするファイルの数。パフォーマンスの問題が発生した場合は、このパラメーターを調整してください。
[一括ロード] および Snowpipe Streaming ロード方法の説明については、「基本設定」を参照してください。
Teradata ターゲットにのみ関連
Teradata がターゲットである場合は、レプリケーション タスクでこれらの設定を構成します。
基本設定
- TPT オペレーター: [ロード] または [ストリーム] を選択します。デフォルトは [ストリーム] です。
- JSON 形式: Text、BSON、または UBJSON を選択します。デフォルトは Text です。
TPT オペレータ モード
TPT オペレーターにより、Teradata へのデータの書き込み方法が決定されます。
-
ストリーム (デフォルト): Teradata TPump プロトコルを使用して、ほぼリアルタイムで高速な DML トランザクションを実行します。DML 操作の実行中もテーブルに対してクエリを実行できます。このモードでは、進行中の変更処理に対する制約が少なくなっています。ソースがこの演算子をサポートしている場合、データベース ユーザーには
CREATE MACRO権限も必要になる場合があります。 -
ロード: Teradata FastLoad プロトコルを使用して、空のテーブルに大量のデータをロードします。ターゲット テーブルは空である必要があり、セカンダリ インデックスを持つことはできません。その制約がタスクの処理要件に適合する場合にのみ、このモードを使用してください。
JSON 形式オプション
Teradata での JSON 列の保存方法を指定します。
- Text (デフォルト): JSON データをテキストとして保存します。
- BSON: JSON データを BSON 形式で保存します。
- UBJSON: JSON データを UBJSON 形式で保存します。
詳細な TPT 属性
[TPT 属性] で、次のオプションを設定します。
- バッファー サイズ: Teradata へのロード パーセルの送信に使用する出力バッファー サイズを設定します。1 ~ 64 KB の値を入力します。
- バッファー: 使用するリクエスト バッファーの数を設定します。2 以上の値を入力します。
- 明示的なセッション範囲: Teradata へのログオンを許可するセッションの最小数および/または最大数を設定します。
- 最大値: セッションの最大数を設定します。値は、利用可能なアクセス モジュール プロセッサー (AMP) の数を超えることはできません。
- 最小: セッションの最小数を設定します。
- 動的ステートメント パッキング: ストリーム ドライバーが現在のストリーム ジョブに対して可能な最大のパッキングを決定できるようにするには、このオプションを選択します。
- ステートメント パッキング: ストリーム モードで複数ステートメント リクエストにパックするステートメントの数を設定します。2 ~ 600 の値を入力します。このオプションは、動的ステートメント パッキングが選択されていない場合に使用できます。
Kafka ターゲットにのみ関連
メッセージのプロパティ
圧縮
必要に応じて、利用可能な圧縮方法 (Snappy または Gzip) のいずれかを選択します。デフォルトでは [なし] になっています。
データ メッセージの公開
次の [データの公開先] オプションのいずれかを選択します。
- 特定のトピック: データを単一のトピックに公開します。トピック名を入力するか、参照ボタンを使用して目的のトピックを選択します。
-
テーブルごとに個別のトピック: ソース テーブル名に対応する複数のトピックにデータを公開します。
ターゲット topic 名は、ピリオドで区切られたソース スキーマ名とソース テーブル名で構成されます (例: dbo.Employees)。これらの topic を事前に準備する必要があるため、ターゲット topic 名の形式は重要です。
トピックが存在しない場合は、データタスクが実行時にトピックを作成できるように、auto.create.topics.enable=true を使用してブローカーを設定します。存在しない場合、タスクは失敗します。
データセット レベルでこの設定を上書きする方法については、「Kafka に公開するときに個々のデータセットのタスク設定をオーバーライドする」を参照してください。
メッセージ キー
利用可能なオプションを 1 つ選択します。
-
プライマリ キー列: 各メッセージのメッセージ キーには、プライマリ キー列の値が含まれます。
[パーティション戦略] として [メッセージ キーで] が選択されている場合、同じプライマリ キー値で構成されるメッセージは同じパーティションに書き込まれます。
-
スキーマとテーブル名: 各メッセージのメッセージ キーには、スキーマとテーブル名の組み合わせが含まれます (例: dbo+Employees)。
[パーティション戦略] として [メッセージ キーで] が選択されている場合、同じスキーマとテーブル名で構成されるメッセージは同じパーティションに書き込まれます。
- なし: メッセージ キーなしでメッセージを作成します。
データセット レベルでこの設定を上書きする方法については、「Kafka に公開するときに個々のデータセットのタスク設定をオーバーライドする」を参照してください。
パーティション戦略
[ランダム] または [メッセージ キーで] のいずれかを選択します。[ランダム] を選択した場合、各メッセージはランダムに選択されたパーティションに書き込まれます。[メッセージ キーで] を選択した場合、選択した [メッセージ キー] (上記参照) に基づいてメッセージがパーティションに書き込まれます。
メタデータ メッセージの公開
サブジェクト名戦略
最初の戦略 (スキーマとテーブル名) は Qlik 独自の戦略であり、他の 3 つは標準の Confluent サブジェクト名戦略です。
利用可能なサブジェクト名戦略を 1 つ選択します。
- スキーマとテーブル名 (既定)
- トピック名
- レコード名
- トピックとレコード名
Confluent のサブジェクト名戦略の詳細については、「サブジェクト名戦略」を参照してください。
サブジェクト互換モード
[サブジェクト互換性モード] ドロップダウン リストから、次の互換性モードのいずれかを選択します。
-
スキーマ レジストリのデフォルトを使用: スキーマ レジストリ サーバー構成から互換性レベルを取得します。
-
後方 - 最新のスキーマのみ: 新しいスキーマは、対応するデータと、最新の登録済みスキーマによって生成されたデータのみを読み取ることができます。
-
後方推移 - 以前のすべてのスキーマ: 新しいスキーマは、以前に登録されたすべてのスキーマによって生成されたデータを読み取ることができます。
-
前方 - 最新のスキーマのみ: 最新の登録済みスキーマは、新しいスキーマによって生成されたデータを読み取ることができます。
-
前方推移 - 以前のすべてのスキーマ: 以前に登録されたすべてのスキーマは、新しいスキーマによって生成されたデータを読み取ることができます。
-
完全 - 最新のスキーマのみ: 新しいスキーマは、最新の登録済みスキーマと後方互換性および前方互換性があります。
-
完全推移 - 以前のすべてのスキーマ: 新しいスキーマは、以前に登録されたすべてのスキーマと後方互換性および前方互換性があります。
-
なし
- 選択したサブジェクト名戦略によっては、一部の互換性モードが利用できない場合があります。
-
スキーマ レジストリにメッセージを公開する場合、新しく作成されたすべての [コントロール テーブル サブジェクト] の既定のサブジェクト互換モードは、選択した [サブジェクト互換モード] に関係なく、 [なし] になります。
選択した [サブジェクト互換性モード] をコントロール テーブルにも適用する場合は、Kafka ターゲット コネクタの setNonCompatibilityForControlTables 内部パラメーターを false に設定します。
プロキシを使用して Confluent Schema Registry に接続する
このオプションは、Confluent Schema Registryに公開する場合にのみサポートされます。
Data Movement gateway がプロキシサーバーを使用するように構成されている場合は、オンに切り替えます。
メッセージの属性
既定のメッセージ属性を上書きするカスタム メッセージ属性を指定できます。これは、コンシューマー アプリケーションが特定の形式でメッセージを処理する必要がある場合に役立ちます。
カスタム メッセージ属性は、タスク レベルとテーブル レベルの両方で定義できます。属性がタスクおよびテーブルの両方のレベルで定義されている場合、テーブルに定義されたメッセージ属性は、タスクに定義されたものよりも優先されます。
データセット レベルでのメッセージ属性の上書きについては、「Kafka に公開するときに個々のデータセットのタスク設定をオーバーライドする」を参照してください。
階層構造のメッセージはサポートされていません。
一般的なルールと使用ガイドライン
カスタム メッセージを定義する際は、以下のルールと使用ガイドラインを考慮することが重要です。
セクション名
次の命名規則が適用されます。
- セクション名は、a-z、A-Z、または _ (アンダースコア) の文字で開始する必要があり、その後に a-z、A-Z、0-9、_ の文字を続けることができます。
- [レコード名] と [キー名セクション] (スラッシュで終わらないもの) を除き、セクション名からスラッシュを削除すると、関連するセクションの階層がフラット化されます (以下の「スラッシュ」を参照)。
- [レコード名] と [キー名] を除くすべてのセクション名は削除できます (以下の「削除」を参照)。
-
[データ名] と [レコードの前データを含める] セクション名は、両方削除できません。
-
[データ名] と [レコードの前データを含める] セクション名は、同じにできません。
UI の一部のセクション名はスラッシュで終わります (例:beforeData/). スラッシュの目的は、メッセージ内の異なるセクションの階層を維持することです。スラッシュが削除されると、次のようになります。
- そのセクションの階層構造がフラット化され、セクション名がメッセージから削除されます。
- セクション名は、実際のメタデータの前に直接、またはセクション名に付加した区切り文字 (例: アンダースコア) を使用して付加されます。
headers/ がスラッシュで指定されている場合のデータ メッセージの例:
		"message":{
		        "data":{
			      "COL1": "159",
			      "COL2": "159"
                       },
                       "beforeData": null,
		        "headers": {
			"operation": "INSERT",
			"changeSequence": "2018100811484900000000233",
headers_ がスラッシュではなくアンダースコアで指定されている場合のデータ メッセージの例:
		"message":{
		        "data":{
			      "COL1": "159",
			      "COL2": "159"
                       },
                       "beforeData": null,
                       "headers_operation": "INSERT",
			"headers_changeSequence": "2018100811484900000000233",
メッセージからセクション名を削除すると、そのセクションの階層構造がフラット化されます。その結果、そのセクションのすべてのデータが、前のセクションの内容のすぐ下に表示されます。
headers セクション名を含むデータ メッセージの例:
	        "message":{
		        "data":{
			      "COL1": "159",
			      "COL2": "159"
                       },
		        "headers": {
			"operation": "INSERT",
			"changeSequence": "2018100811484900000000233",
headers セクション名を含まないデータメッセージの例:
	        "message":{
		        "data":{
			      "COL1": "159",
			      "COL2": "159"
                       },
                       "beforeData": null,
                       "operation": "INSERT",
			"changeSequence": "2018100811484900000000233",
変数
行の最後にある  ボタンをクリックすると、名前に変数を追加できます。次の変数を使用できます。
- SERVER_NAME - Data Movement gateway サーバーのホスト名
- TARGET_TABLE_NAME - テーブルの名前
- TARGET_TABLE_OWNER - テーブルの所有者
- TASK_NAME - データ タスクの名前
TARGET_TABLE_OWNER 変数は、 [レコード名] および [キー名] オプションでは使用できません (以下の表を参照)。
カスタム メッセージ属性の定義
カスタム メッセージ形式を定義するには、 [カスタム設定を使用] をオンにし、以下の表に従ってオプションを設定します。
既定のメッセージ属性に戻すには、 [カスタム設定を使用] をオフにします。
| オプション | 説明 |
|---|---|
|
オンにすると (既定)、メッセージに一意の識別子が含まれます。これはピリオドで区切られた文字列である必要があります。ネームスペースはメッセージとメッセージ キーの両方に含まれることに注意してください。 例: mycompany.queue.msg デフォルト名: com.attunity.queue.msg.{{TASK_NAME}}.{{TARGET_TABLE_OWNER}}.{{TARGET_TABLE_NAME}} コントロール テーブルのデフォルト名: com.attunity.queue.msg.{{TARGET_TABLE_NAME}} 情報メモ
既定のコントロール テーブル ネームスペースは、UI 経由では変更できません。ただし、既定のコントロール テーブル ネームスペースは以下のとおり変更できます。
|
|
|
レコード名 |
レコード (メッセージ) の名前。 デフォルト名: DataRecord |
|
データ名 |
レコードに含まれるすべてのデータ列。 デフォルト名: data/ |
|
ヘッダーを含める |
オンにすると (既定)、ヘッダー列がメッセージに含まれます。ヘッダー列には、ソース操作に関する追加情報が表示されます。 詳細については、以下の「次のヘッダーを含める」を参照してください。 |
|
ヘッダー ネームスペースを含める |
オンにすると (既定)、ヘッダー列セクションの一意の識別子がメッセージに含まれます。これはピリオドで区切られた文字列である必要があります。 例: headers.queue.msg デフォルト名: com.attunity.queue.msg |
|
ヘッダー名 |
Qlik 列ヘッダーを含むセクションの名前。 デフォルト名: headers/ |
|
利用可能なヘッダー列の説明については、Qlik ヘルプの「データ メッセージを」参照してください。 既定: [外部スキーマ ID] 列を除き、すべての列が既定で含まれます。 |
|
|
レコードの前データを含める |
オンにすると (既定)、UPDATE メッセージに UPDATE 前後の両方のデータが含まれます。 メッセージに UPDATE 投稿データのみを含めるには、オプションをオフにします。。 デフォルト名: beforeData/ |
|
キー名 |
メッセージ キーを含むセクションの名前。 デフォルト名: keyRecord このオプションは次の場合にのみ適用されます。
|
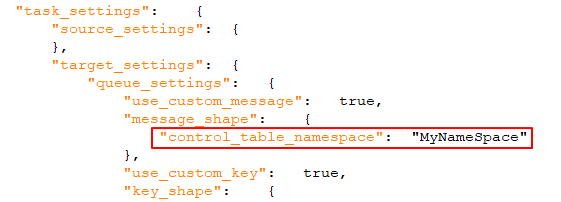
追加設定
-
メッセージの最大サイズ
[メッセージの最大サイズ] 項目で、ブローカーが受信するように構成されているメッセージの最大サイズ (message.max.bytes) を指定します。データタスクは、最大サイズを超えるメッセージを送信しません。
メタデータ
[Basic] (基本)
-
ターゲット テーブル スキーマ
ソース テーブル スキーマを使用しない場合 (またはソース データベースにスキーマがない場合)、ソース テーブルをレプリケートするターゲットのスキーマ。
情報メモOracle ターゲットにレプリケートする場合、既定のターゲット テーブル スキーマは「system」です。この項目を空のままにする場合 (この場合、ソース スキーマが使用される)、ソース スキーマがターゲット上にすでに存在することを確認する必要があります。存在しない場合、タスクは失敗します。情報メモスキーマ名に許可される最大文字数は 128 文字です。
JSON 列のマッピング
互換性のあるソース JSON 列とターゲット JSON 列のマッピング
-
Data Movement gateway を使用してデータ ソースにアクセスする場合、バージョン 2024.11.70 以降が必要です。
このオプションを選択すると、ソース上の JSON カラムはターゲット上の JSON カラムに自動的にマッピングされます。
このオプションの状態や見え方は、以下の要因によって決まります。
-
新規タスク: このオプションは、ソースとターゲットの両方が JSON データ型をサポートしている場合、デフォルトで有効になります。
-
既存のタスク: このオプションは、ソースとターゲットの両方が JSON データ型をサポートしている場合でも、デフォルトで無効になります。これは、ターゲット データが STRING 形式であることを期待する (レガシー動作) 変換などの下流プロセスとの後方互換性を維持するためです。このオプションを無効のままにすることも、下流のプロセスを編集して JSON 形式と互換性を持たせてからこのオプションを有効にすることもできます。
-
新規および既存のタスク: ソースのみが JSON データ型をサポートしている場合、このオプションは表示されません。後の段階でターゲットに JSON サポートが追加された場合、このオプションは表示されるようになりますが、無効のままになります。これは、ターゲット データが STRING 形式であることを期待する (レガシー動作) 変換などの下流プロセスとの後方互換性を維持するためです。
LOB 設定
使用可能な LOB 設定は、選択したレプリケーション ターゲットによって異なります。データ ウェアハウス ターゲットは無制限の LOB 列サイズをサポートしていないため、データ ウェアハウスにレプリケートするときにこのオプションは使用できません。
データ ウェアハウスではないターゲットの LOB 設定
- LOB 列を含めない: ソース LOB 列をレプリケートしない場合は、これを選択します。
-
LOB 列サイズを (KB) に制限: これが既定です。小さい LOB のみをレプリケートする必要がある場合や、ターゲット プラットフォームが無制限の LOB サイズをサポートしていない場合は、このオプションを選択します。この項目に許可される最大値は 102400 KB (100 MB) です。
小さい LOB をレプリケートする場合、ソースからの「ルックアップ」経由ではなく「インライン」でレプリケートされるため、このオプションは [LOB 列サイズを制限しない] オプションよりも効率的です。変更処理中、小さい LOB は通常ソースからの「ルックアップ」を介してレプリケートされます。
制限は、ソース エンドポイントから読み取られる LOB バイト数に適用されます。BLOB 列の場合、ターゲット BLOB サイズは指定された制限に正確に従います。CLOB 列および NCLOB 列の場合、ソース LOB とターゲット LOB の文字セットが同じでない場合、ターゲット LOB サイズが指定された制限と異なる可能性があります。この場合、データ タスクは文字セットの変換を実行し、ソース LOB サイズとターゲット LOB サイズに不一致が生じる可能性があります。
[LOB サイズを制限] の値はバイト単位であるため、サイズは次の式に従って計算する必要があります。
- BLOB: 最大の LOB の長さ。
- NCLOB: 最長の TEXT の文字数を 2 倍した長さ (各文字は 2 バイトとして扱われるため)。データに 4 バイト文字が含まれる場合は 4 倍してください。
- CLOB: 最長の TEXT の文字数 (各文字は UTF8 文字として処理されるため)。データに 4 バイト文字が含まれる場合は 2 倍してください。
情報メモ- 指定したサイズより大きい LOB は切り捨てられます。
- Oracle ソースからの変更処理中、インライン BLOB はインラインでレプリケートされます。
- この設定への変更は、既存のテーブルがリロードされた後にのみ影響します。
-
LOB 列サイズを制限しない: このオプションを選択すると、サイズに関係なく LOB 列がレプリケートされます。
情報メモLOB 列のレプリケートは、パフォーマンスに影響を与える可能性があります。これは、ソース LOB 値を取得するためにレプリケーション タスクでソース テーブルからルックアップを実行する必要がある大規模な LOB 列の場合に特に当てはまります。-
LOB サイズが次以下の場合に最適化: 小さい LOB と大きい LOB の両方をレプリケートする必要があり、ほとんどの LOB が小さい場合は、このオプションを選択します。
情報メモこのオプションは、次のソースとターゲットでのみサポートされます。
-
ソース: Oracle、Microsoft SQL server、MySQL、PostgreSQL、IBM DB2 for LUW
-
ターゲット: Oracle、Microsoft SQL Server、MySQL、PostgreSQL。
このオプションを選択すると、フル ロード中に小さい LOB が「インライン」でレプリケートされ (より効率的)、大きい LOB はソース テーブルからのルックアップを実行することによってレプリケートされます。ただし、変更処理中は、ソース テーブルからのルックアップを実行することにより、小さい LOB と大きい LOB の両方がレプリケートされます。
情報メモこのオプションを選択すると、レプリケーション タスク はすべての LOB サイズをチェックして、どの LOB サイズを「インライン」で転送するかを決定します。指定されたサイズより大きい LOB は、フル LOB モードを使用してレプリケートされます。
したがって、ほとんどの LOB が指定された設定よりも大きいことがわかっている場合は、代わりに [LOB列を無制限にレプリケート] オプションを使用することをお勧めします。
-
-
チャンク サイズ (KB): 必要に応じて、データをターゲットにレプリケートするときに使用する LOB チャンクのサイズを変更します。ほとんどの場合は既定のチャンク サイズで十分ですが、パフォーマンスの問題が発生した場合は、サイズを調整することでパフォーマンスが向上する可能性があります。
情報メモ一部のデータベースでは、データの挿入または更新時にデータ型の検証が行われます。このような場合、データが指定されたチャンク サイズより大きいと、構造化データ型 (XML、JSON、GEOGRAPHY など) のレプリケーションは失敗する可能性があります。
-
サポートされているデータ ウェアハウス ターゲットの LOB 設定
-
LOB 列を含めて列サイズを次に制限 (KB):
タスクに LOB 列を含めることを選択でき、さらに最大 LOB サイズを設定できます。最大サイズより大きい LOB は切り捨てられます。
詳細設定
コントロール テーブル設定
-
コントロール テーブル スキーマ: コントロール テーブルをソース スキーマ (既定) またはターゲット スキーマに作成しない場合は、コントロール テーブルのターゲット スキーマを指定します。
情報メモスキーマ名に許可される最大文字数は 128 文字です。 - テーブルスペースにターゲット コントロール テーブルを作成します: レプリケーション ターゲットが Oracle の場合、ターゲット コントロール テーブルを作成するテーブルスペースを指定します。この項目に情報を入力しない場合、テーブルはターゲット データベースの既定のテーブルスペースに作成されます。
- テーブルスペースにターゲット コントロール テーブルの索引を作成します:レプリケーション ターゲットが Oracle の場合、コントロール テーブルのインデックスを作成するテーブルスペースを指定します。この項目に情報を入力しない場合、インデックスはコントロール テーブルと同じテーブルスペースに作成されます。
- レプリケーション履歴タイムスロット (分): レプリケーション履歴 コントロール テーブル内の各タイムスロットの長さ。既定は 5 分です。
コントロール テーブルの選択
ターゲット プラットフォームに作成するコントロール テーブルを選択します。
| 論理名 | ターゲット内の名前 |
|---|---|
| 適用の例外 | attrep_apply_exceptions |
| レプリケーション ステータス | attrep_status |
| 一時停止のテーブル | attrep_suspended_tables |
| レプリケーション履歴 | attrep_history |
| DDL 履歴 |
attrep_ddl_history DDL 履歴テーブルは、次のターゲット プラットフォームでのみサポートされています。
|
コントロール テーブルの詳細については、「コントロール テーブル」を参照してください。
フル ロード
[Basic] (基本)
これらの設定は、データ タスクの準備段階、およびテーブルがリロードされるたびに適用されます。
ターゲット テーブルがすでに存在する場合: 次のいずれかを選択して、データをターゲット テーブルにロードする方法を決定します。
ターゲット テーブルを削除または切り捨てるオプションは、そのような操作がソース エンドポイントでサポートされている場合にのみ関係します。
-
テーブルのドロップと作成: ターゲット テーブルがドロップされ、その場所に新しいテーブルが作成されます。
情報メモレプリケーション タスク コントロール テーブルはドロップされません。ただし、関連付けられたタスクがリロードされると、ドロップされた一時停止テーブルも attrep _suspended_tables コントロール テーブルから削除されます。
-
ロード前に切り捨て: データはターゲット テーブルのメタデータに影響を与えることなく切り捨てられます。このオプションが選択されている場合、 [フル ロードの完了後に主キーまたは一意のインデックスを作成] オプションを有効にしても効果はありません。
情報メモMicrosoft Fabric がターゲット プラットフォームの場合はサポートされません。 - 無視: ターゲット テーブルの既存のデータとメタデータは影響を受けません。新しいデータがテーブルに追加されます。
詳細設定
パフォーマンスのチューニング
データのレプリケーションが極端に遅い場合は、次のパラメータを調整するとパフォーマンスが向上する可能性があります。
- テーブルの最大数: ターゲットに一度にロードする、テーブルの最大数を入力します。既定値は 5 です。
-
トランザクション整合性タイムアウト (秒): フル ロード操作を開始する前に、開いているトランザクションが閉じるまでレプリケーション タスクが待機する秒数を入力します。既定値は 600 (10 分) です。レプリケーション タスクは、オープンなトランザクションがある場合でも、タイムアウト値に達するとフル ロードを開始します。
情報メモフル ロードの開始時にオープンしていたが、タイムアウト値に達した後にのみコミットされたトランザクションをレプリケートするには、ターゲット テーブルをリロードする必要があります。 - フル ロード時のコミット レート: 一緒に転送できるイベントの最大数。既定値は 10000 です。
フル ロードの完了後
フル ロードの完了後にタスクが自動的に停止するように設定できます。これは、タスクの変更の適用 (CDC) フェーズが始まる前に、ターゲット テーブルに対して DBA 操作を実行する必要がある場合に便利です。
フル ロード中に、ソーステーブルで実行された DML 操作がキャッシュされます。フル ロードが完了すると、キャッシュされた変更がターゲット テーブルに自動的に適用されます (以下で説明する [キャッシュされた変更の適用前/後] オプションが無効になっている場合)。
-
プライマリ キーまたは一意のインデックスを作成: フル ロードが完了するまで、ターゲットのプライマリ キーまたは一意のインデックスの作成を遅らせる場合は、このオプションを選択します。
情報メモこの設定は、SaaS アプリケーション コネクタを使用するタスクでは利用できません。 - タスクの停止:
情報メモ
これらの設定は、データ ウェアハウス ターゲットにレプリケートする場合は使用できません。
-
キャッシュされた変更が適用される前: フル ロードの完了後にタスクを停止する場合に選択します。
-
キャッシュされた変更が適用された後: タスク内のすべてのテーブルでデータの一貫性が確保され次第、タスクを停止する場合に選択します。
情報メモフル ロードの完了後にタスクを停止するように構成する場合は、次の点に注意してください。
- フルロードが完了してもタスクは停止しません。タスクは、変更の最初のバッチがキャプチャされた後にのみ停止されます (これがタスクを停止するトリガーとなるため)。ソース データベースが更新される頻度によっては、時間がかかる場合があります。タスクが停止すると、タスクが再開されるまで変更はターゲットに適用されません。
- [キャッシュされた変更の適用前] を選択すると、キャッシュされた変更は最後のテーブルがフル ロードを完了した後にのみテーブル に適用されるため (すでにフル ロードを完了したテーブルを含む)、パフォーマンスに影響を与える可能性があります。
- このオプションが選択され、フル ロード処理 (フル ロードおよび変更の適用タスク) 中にソース テーブルの 1 つで DDL が実行されると、レプリケーション タスクはテーブルをリロードします。これは事実上、タスクが停止する前に、ソース テーブルで実行された DML 操作がターゲットにレプリケートされることを意味します。
-
初期ロード用
| キャッシュされたデータを使用 |
このオプションを使用すると、 [フル データ スキャン] を選択してメタデータを生成するときに読み込まれたキャッシュ データを使用できます。 データはすでにソースから読み込まれているため、API の使用とクォータに関するオーバーヘッドが軽減されます。最初のデータ スキャン以降の変更は、変更データ キャプチャ (CDC) によって取得できます。 |
| ソースからデータをロード |
このオプションは、データ ソースから新しいロードを実行します。このオプションは次の場合に有効です。
|
変更を適用
これらの設定は、 [変更の適用] レプリケーション モードが有効になっている場合にのみ使用できます。
[Basic] (基本)
ターゲットに適用する DDL 変更のタイプを選択してください
次のオプションは、対応するソース テーブルで実行される DDL 操作をターゲット テーブルでも実行するかどうかを決定します。
-
テーブルのドロップ: ソース テーブルがドロップされたときに、ターゲット テーブルもドロップするように選択します。
情報メモKafka がターゲット プラットフォームの場合はサポートされません。 -
テーブルの切り捨て: ソース テーブルが切り捨てられたときに、ターゲット テーブルも切り捨てるように選択します。
情報メモMicrosoft Fabric がターゲット プラットフォームの場合はサポートされません。 -
テーブルの変更: ソース テーブルが変更されたときに、ターゲット テーブルも変更するように選択します。
情報メモターゲット プラットフォームが Kafka の場合、テーブルの名前変更はサポートされません。
変更処理のチューニング
-
一括変更を複数のテーブルに同時に適用: このオプションを選択すると、複数のソース テーブルからの変更を適用するときのパフォーマンスが向上します。
情報メモこのオプションは、次の場合にのみサポートされます。
- [変更適用モード] が [バッチ最適化] に設定されている。詳細は、レプリケーションの設定をご覧ください。
- レプリケーション ターゲットは、MySQL、PostgreSQL、Oracle、Google BigQuery ではありません。
-
テーブルの最大数: 一括変更を同時に適用するテーブルの最大数です。既定は 5 になっており、最大値は 50、最小値は 2 です。
[一括変更を複数のテーブルに同時に適用] オプションが有効になっている場合、次の制限が適用されます。
-
環境とテーブル エラーのタスク エラー処理ポリシーの既定は変更されませんが、データ エラーと適用の競合エラーの既定は次のようになります。
- データ エラー:
- データ切り捨てエラー: 例外テーブルにレコードを記録
- その他のデータ エラー: テーブルの中断
- 適用の競合エラー:
- 削除: レコードを無視
挿入: 既存のターゲット レコードを更新
情報メモこれは、Snowflake ターゲットには関係ありません (Snowflake は主キーをサポートしていないため)。- 更新: レコードを無視
- エスカレーション アクション:
- データ エラーと適用の競合の両方に対するエスカレーション アクションはサポートされていません。
- attrep_アプリly_Exception コントロール テーブルはサポートされていません。
- データ エラーの場合:
- [例外テーブルにレコードを記録] オプションは、データ切り捨てエラーにのみ使用できます。
- [無視する] オプションは使用できません。
- 適用の競合の場合:
- [例外テーブルへのログ レコード] オプションは使用できません。
[無視] のオプションは、 [更新を適用するためのレコードが見つかりません] の適用の競合の場合にのみ使用できます。
- データ エラー:
関連項目: エラー処理。
-
-
変更処理ステートメントごとに適用される変更数を次に制限: 1 つの変更処理ステートメントで適用される変更の数を制限するには、このチェック ボックスをオンにし、必要に応じてデフォルト値を変更します。既定値は 10,000 です。
情報メモこのオプションは、ターゲット MySQL、PostgreSQL、Oracle、Google BigQuery でのみサポートされます。
詳細設定
「変更処理のチューニング」を参照してください。
変更の保存
これらの設定は、 [変更の保存] レプリケーション モードが有効になっている場合にのみ使用できます。
[Basic] (基本)
DDL オプション
次のオプションのいずれかを選択して、ソース テーブルに対する DDL 操作を処理する方法を決定します。
- 変更テーブルに適用: ソース テーブルに対する DDL 操作 (追加される列など) は、対応する変更テーブルにのみ適用されます。
- 無視: ソーステーブルに対するすべての DDL 操作は無視されます。
詳細設定
更新時
更新前のデータと更新後のデータの両方を保存するには、 [変更前イメージと変更後イメージを保存する] を選択します。選択しない場合は、更新後のデータのみが保存されます。
変更テーブルの作成
次のセクションでは、変更テーブルに変更を保存するときに使用できるオプションについて説明します。
- サフィックス: すべての変更テーブルのヘッダー列のプレフィックスとして使用する文字列を指定します。規定値は __ct です。変更テーブル名は、ターゲット テーブルの名前にサフィックスが追加されたものです。たとえば、既定値を使用すると、変更テーブルの名前は HR__ct になります。
- ヘッダー列のプレフィックス: すべての変更テーブルのヘッダー列のプレフィックスとして使用する文字列を指定します。既定値は header__ です。たとえば、既定値を使用すると、ヘッダー列 stream_position は header__stream_position になります。
変更テーブルの詳細については、「変更テーブルの使用」を参照してください。
フル ロード開始時に変更テーブルが存在する場合: 次のいずれかを選択して、フル ロード レプリケーションの開始時に変更テーブルをロードする方法を決定します。
- ドロップして変更テーブルを作成: テーブルがドロップされ、その場所に新しいテーブルが作成されます。
-
古い変更を削除し、変更を既存の変更テーブルに保存: テーブルのメタデータに影響を与えることなく、データは切り捨てられて追加されます。
情報メモMicrosoft Fabric がターゲット プラットフォームの場合はサポートされません。 - 古い変更を保持し、新しい変更を既存の変更テーブルに保存: 既存の変更テーブルのデータとメタデータは影響を受けません。
テーブルのヘッダー列
変更テーブルのヘッダー列には、操作のタイプ (INSERT など) やコミット時間など、変更処理操作に関する情報が表示されます。このすべての情報が必要ない場合は、ヘッダー列を選択して (または 1 つも選択せずに) 変更テーブルを作成するように 移動 タスクを構成することで、ターゲット データベースのフットプリントを削減できます。
ヘッダー列の説明については、「 変更テーブル」を参照してください。
エラー処理
[Basic] (基本)
適用の競合
INSERT 適用時の重複キー: INSERT 操作で競合が発生した場合に実行するアクションを選択します。
-
無視: タスクは続行され、エラーは無視されます。
-
既存のターゲット レコードを更新: INSERTED ソース レコードと同じ主キーを持つターゲット レコードが更新されます。
- 例外テーブルにレコードを記録 (既定): タスクは続行され、エラーは例外テーブルに書き込まれます。
-
テーブルを一時停止: タスクは続行されますが、エラー レコードのあるテーブルのデータはエラー状態に移行し、そのデータはレプリケートされません。
- タスクを停止: タスクは停止され、手動による操作が必要となります。
UPDATE の適用対象レコードが見つかりません: UPDATE 操作で競合が発生した場合に実行するアクションを選択します。
- 無視: タスクは続行され、エラーは無視されます。
-
不足しているターゲット レコードを挿入: 不足しているターゲット レコードがターゲット テーブルに挿入されます。ソース エンドポイントが Oracle の場合、このオプションを選択するには、すべてのソース テーブル列に対してサプリメンタル ロギングを有効にする必要があります。
- 例外テーブルにレコードを記録 (既定): タスクは続行され、エラーは例外テーブルに書き込まれます。
-
テーブルを一時停止: タスクは続行されますが、エラー レコードのあるテーブルのデータはエラー状態に移行し、そのデータはレプリケートされません。
- タスクを停止: タスクは停止され、手動による操作が必要となります。
詳細設定
データ エラー処理は、変更適用レプリケーション モードでのみサポートされます (フル ロードはサポートなし)。
データ エラー
データ切り捨てエラーの場合: 1 つ以上の特定のレコードで切り捨てが発生した場合に実行する処理を選択します。リストから次のいずれかを選択できます。
- 無視: タスクは続行され、エラーは無視されます。
- 例外テーブルへのログ レコード (既定): タスクは続行され、エラーは例外テーブルに書き込まれます。
- テーブルを一時停止: タスクは続行されますが、エラー レコードのあるテーブルのデータはエラー状態に移行し、そのデータはレプリケートされません
- タスクを停止: タスクは停止され、手動による操作が必要となります。
その他のデータ エラーの場合: 1 つ以上の特定のレコードでエラーが発生した場合に実行する処理を選択します。リストから次のいずれかを選択できます。
- 無視: タスクは続行され、エラーは無視されます。
- 例外テーブルへのログ レコード (既定): タスクは続行され、エラーは例外テーブルに書き込まれます。
- テーブルを一時停止: タスクは続行されますが、エラー レコードのあるテーブルのデータはエラー状態に移行し、そのデータはレプリケートされません
- タスクを停止: タスクは停止され、手動による操作が必要となります。
その他のデータ エラーが発生した場合にエラー処理をエスカレートします (テーブルごと): このチェック ボックスをオンにすると、非切り捨てデータ エラーの数 (テーブルごと) が指定された量に達したときにエラー処理がエスカレートされます。有効な値は 1 ~ 10,000 です。
エスカレーション アクション: エラー処理がエスカレートされたときに実行される処理を選択します。使用できるアクションは、上記の [その他のデータ エラーの場合] ドロップダウン リストから選択したアクションに応じて異なります。
-
テーブルを一時停止 (既定): タスクは続行されますが、エラー レコードのあるテーブルのデータはエラー状態に移行し、そのデータは 移動済み されません。
情報メモ動作は変更処理モードに応じて異なります。
-
トランザクションの適用モードでは、最後の変更は 移動済み されません。
-
バッチ最適化の適用モードでは、データがまったく 移動済み されない、または部分的にのみ 移動済み される状況が発生する可能性があります。
-
- タスクを停止: タスクは停止され、手動による操作が必要となります。
- 例外テーブルにレコードを記録: タスクは続行され、レコードは例外テーブルに書き込まれます。
テーブル エラー
テーブル エラーが発生した場合: ドロップダウン リストから次のいずれかを選択します。
- テーブルを一時停止 (既定): タスクは続行されますが、エラー レコードのあるテーブルのデータはエラー状態に移行し、そのデータはレプリケートされません。
- タスクを停止: タスクは停止され、手動による操作が必要となります。
テーブル エラーが次の値に達した場合に処理をエスカレート (テーブルごと): このチェック ボックスをオンにすると、テーブル エラーの数 (テーブルごと) が指定された量に達した場合にエラー処理をエスカレートします。有効な値は 1 ~ 10,000 です。
エスカレーション アクション: テーブル エラーのエスカレーション ポリシーは [タスクを停止] に設定されており、変更できません。
競合を適用
DELETE を適用するためのレコードが見つかりません: DELETE 操作で競合が発生した場合に実行するアクションを選択します。
- 無視: タスクは続行され、エラーは無視されます。
- 例外テーブルにレコードを記録: タスクは続行され、レコードは例外テーブルに書き込まれます。
- テーブルを一時停止: タスクは続行されますが、エラー レコードのあるテーブルのデータはエラー状態に移行し、そのデータはレプリケートされません。
- タスクを停止: タスクは停止され、手動による操作が必要となります。
適用の競合が発生した場合、エラー処理をエスカレートします (テーブルごと): このチェック ボックスをオンにすると、適用の競合の数 (テーブルごと) が指定された量に達した場合にエラー処理をエスカレートします。有効な値は 1 ~ 10,000 です。
エスカレーション アクション: エラー処理がエスカレートされたときに実行される処理を選択します。
- 例外テーブルにレコードを記録 (既定): タスクは続行され、エラーは例外テーブルに書き込まれます。
-
テーブルを一時停止: タスクは続行されますが、エラー レコードのあるテーブルのデータはエラー状態に移行し、そのデータはレプリケートされません。
情報メモ動作は変更処理モードに応じて異なります。
-
トランザクションの適用モードでは、最後の変更はレプリケートされません
-
バッチ最適化の適用モードでは、データのレプリケーションが行われないか、データのレプリケーションが部分的に行われる可能性があります。。
-
-
タスクを停止: タスクは停止され、手動による操作が必要となります。
環境エラー
-
最大再試行数: このオプションを選択すると、復元可能な環境エラーが発生した場合にタスクを再試行する最大回数を指定できます。タスクが指定された回数再試行されると、タスクは停止され、手動による操作が必要となります。
タスクを再試行しない場合は、チェック ボックスをオフにするか、「0」を指定します。
タスクを無限に再試行するには、「-1」を指定します。
-
再試行の間隔 (秒): カウンターを使用して、システムがタスクを再試行するまでに待機する秒数を選択または入力します。
有効な値は 0 ~ 2,000 です。
-
- 長時間の停止の場合は再試行間隔を長くする: 長時間停止した場合の再試行間隔を長くするには、このチェック ボックスをオンにします。このオプションを有効にすると、最大再試行間隔に達するまで、各再試行と次の再試行の間隔が 2 倍になります (指定された最大間隔に従って再試行を継続します)。
- 最大再試行間隔 (秒): [長時間の停止の場合は再試行間隔を長くする] オプションが有効になっている場合、カウンターを使用して、タスクの再試行間隔を待機する秒数を選択または入力します。有効な値は 0 ~ 2,000 です。
変更処理のチューニング
トランザクション オフロードのチューニング
-
次の場合に、進行中のトランザクションをディスクにオフロードします
レプリケーション タスクでは通常、ソースやターゲットに完全にコミットされるまで、トランザクション データがメモリ内に保持されます。ただし、割り当てられたメモリより大きいトランザクション、または指定された制限時間内にコミットされないトランザクションは、ディスクにオフロードされます。
- トランザクション メモリ サイズが超過 (MB): すべてのトランザクションがディスクにオフロードされる前に、メモリで占有できる最大サイズ。規定値は 1024 です。
- トランザクション期間が次を超えています (秒): 各トランザクションがディスクにオフロードされるまでに、メモリに留まることができる最大時間。期間は、レプリケーション タスクがトランザクションのキャプチャを開始した時間から計算されます。規定値は 60 です。
バッチ チューニング
このタブの設定は、 [変更を適用] モードに応じて決定されます。
「適用モード」が「バッチ最適化」の場合にのみ使用できる設定
- バッチ変更を一定間隔で適用する:
-
Larger than (最小時間): バッチ変更を適用する際の、各適用間の最小待機時間。既定値は 1 です。
Longer than (最小時間) の値を増やすと、変更がターゲットに適用される頻度が減少し、一方でバッチのサイズが増加します。これにより、大規模なバッチの処理用に最適化されたターゲット データベースに変更を適用するときのパフォーマンスが向上します。
- Less than (最大時間): バッチ変更を適用する際の、各適用間の最大待機時間 (タイムアウトを宣言するまで)。つまり、許容できる最大の待機時間のことです。既定値は 30 です。この値により、Longer than (最小時間) の値に達した後、変更を適用するまでの最大待機時間が決定されます。
-
処理メモリ (MB) が次を超えた場合にバッチを強制適用: バッチ最適化の適用モードで前処理に使用するメモリの最大量。既定値は 500 です。
最大バッチ サイズについては、この値をレプリケーション タスクに割り当て可能な最大のメモリ量に設定します。これにより、大規模なバッチの処理用に最適化されたターゲット データベースに変更を適用するときのパフォーマンスが向上します。
「適用モード」が「トランザクション」の場合にのみ使用できる設定
次の設定は、「トランザクション」適用モードで作業する場合にのみ適用されます。Snowflake にレプリケートする場合、適用モードは「トランザクション」のみ使用でき (選択不可)、 [ロード方法] は Snowpipe Streaming であることに注意してください。
-
トランザクションごとの最小変更数: 各トランザクションに含める変更の最小数。既定値は 1000 です。
情報メモ変更の数がトランザクションごとの最小変更数の値以上の場合、または以下で説明する適用前にトランザクションをバッチ処理する最大時間 (秒) の値に達した場合の、いずれかの先に発生したほうのタイミングでターゲットに変更を適用します。ターゲットに適用される変更の頻度はこれら 2 つのパラメーターによって制御されるため、ソース レコードへの変更がターゲット レコードにすぐに反映されない場合があります。
- 適用前にトランザクションをバッチ処理する最大時間 (秒): タイムアウトを宣言するまでにトランザクションをバッチで収集する最大時間。既定値は 1 です。
Interval (インターバル)
-
次の頻度で変更を読み込む (分)
ソースからの変更の読み取り間隔 (分単位)。有効な範囲は 1 ~ 1440 です。
情報メモこのオプションは、以下を使用するタスク専用です。
- Data Movement gateway
- [変更を適用] または [変更を保存] の更新方法
変更をチェック
-
デルタ抽出間隔に従う: このオプションを選択すると、データ タスクは [デルタ抽出間隔] に従って変更をチェックします。
情報メモ間隔は各「ラウンド」の後に開始されます。ラウンドは、データ タスクがソース テーブルから変更を読み取り、それをターゲットに送信 (単一のトランザクションとして) するのにかかる時間として定義できます。ラウンドの長さはテーブルの数や変更に応じて異なります。したがって、間隔を 10 分に指定し、ラウンドに 4 分かかる場合、変更をチェックする実際の時間は 14 分になります。-
デルタ抽出間隔: システムからデルタが抽出される頻度。既定は 60 秒ごとになっています。
-
-
スケジュールどおり: このオプションを選択すると、データ タスクはデルタを 1 回抽出して停止します。その後はスケジュールどおりに実行が継続されます。
情報メモこのオプションは、CDC サイクル間の間隔が 24 時間以上の場合にのみ関連します。スケジュールに関する情報:
-
レプリケーションプロジェクトの「データタスクのレプリケート」については、「タスクのスケジューリング」を参照してください
-
その他のチューニング
ステートメントのキャッシュ サイズ (ステートメントの数)
後で実行するためにサーバーに保存する準備済みステートメントの最大数 (ターゲットに変更を適用する場合)。既定値は 50 です。最大値は 200 です。
プライマリ キー列を更新する際の DELETE と INSERT
このオプションは、 [変更の保存] レプリケーション モードが有効な場合にのみ使用可能であり、ソース データベースでフル サプリメンタル ロギングが有効になっている必要があります。
DELETE 時にトームストーンを送信する
このオプションを選択すると、メッセージ キーのみが設定されます。メッセージ自体は null になり、アイテムが削除されたことを示します。これにより、コンシューマーは DELETE 操作が実行されたことを検出できます。
タスク リカバリ データをターゲット データベースに保存
タスク固有のリカバリ情報をターゲット データベースに保存するには、このオプションを選択します。このオプションを選択すると、レプリケーション タスク はターゲット データベースに attrep_txn_state という名前のテーブルを作成します。このテーブルには、Data Movement gateway データ フォルダー内のファイルが破損した場合、またはデータ フォルダーを含むストレージ デバイスに障害が発生した場合にタスクを復元するために使用できるトランザクション データが含まれています。
SQL MERGE を使用して変更を適用
このオプションが選択されていない場合、レプリケーション タスクは、Net Changes テーブル内の異なる変更タイプごとに個別の一括 INSERT、UPDATE、および DELETE ステートメントを実行します。
この方法は非常に効率的ですが、このオプションをサポートするエンドポイントで作業する場合は、[SQL MERGE を使用して変更を適用] オプションを有効にするとさらに効率的になります。
これには以下の理由があります。
- テーブルごとに実行される SQL ステートメントの数が 3 から 1 に削減されます。大規模で不変なファイルベースのクラウド データベース (Google Cloud BigQuery など) でのほとんどの UPDATE 操作では、影響を受けるファイルの書き換えが行われます。このような操作により、テーブルごとの SQL ステートメントが 3 つから 1 つに削減されることは非常に重要です。
- ターゲット データベースは Net Changes テーブルを 1 回スキャンするだけで済むため、I/O が大幅に削減されます。
挿入の最適化
[SQL MERGE を使用して変更を適用] が [挿入の最適化] オプションとともに選択され、変更が INSERT のみで構成されている場合、レプリケーション タスクは SQL MERGE を使用する代わりに INSERT を実行します。これにより通常はパフォーマンスが向上し、コストが削減されますが、ターゲット データベースに複製レコードが作成される可能性もあることに注意してください。
- [SQL MERGE を使用して変更を適用] および [挿入の最適化] オプションは、次のターゲット エンドポイントで構成されたタスクでのみ使用できます。
- Google Cloud BigQuery
- Databricks
- Snowflake
- [SQL MERGE を使用して変更を適用] および [挿入の最適化] オプションは、次のソース エンドポイントではサポートされていません。
- Salesforce
- Oracle
-
[SQL MERGE を使用して変更を適用] オプションが有効になっている場合:
- 致命的でないデータ エラーまたは回復できないデータ エラーは、テーブル エラーとして処理されます。
- 次の設定では、競合の適用エラー処理ポリシーは編集できません。
- DELETE を適用するためのレコードが見つかりません: レコードを無視
INSERT 適用時の重複キー: 既存のターゲット レコードを更新
情報メモ[挿入の最適化] オプションも選択されている場合、[INSERT を適用するときにキーを複製] オプションは [ターゲット内の複製を許可] に設定されます。- UPDATE を適用するためのレコードが見つかりません: 不足しているターゲット レコードを挿入
- エスカレーション アクション: 例外テーブルにレコードを記録
- 次の [その他のデータ エラー] [データ エラー処理ポリシー] オプションは使用できません。
- レコードを無視する
- 例外テーブルにレコードを記録
- 実際の SQL MERGE 操作は、最終ターゲット テーブルに対してのみ実行されます。INSERT 操作は、中間変更テーブルに対して実行されます ([変更の適用] または [変更の保存] レプリケーション モードが有効な場合)。
トランザクションの適用
データ ウェアハウス ターゲットにレプリケートする場合、または Data Movement gateway を使用していない場合は、 [適用モード] は常に [バッチ最適化済み] であるため、これらのオプションは関係ありません (1 つの例外あり)。
ただし、Snowflake にレプリケートし、 [ロード方法] が Snowpipe streaming に設定されている場合、例外となります。
次の設定は、「トランザクション」適用モードで作業する場合にのみ使用できます。データベースへのレプリケーションでは、 [適用モード] を [バッチ最適化] または [トランザクション] のいずれかに設定できます。ただし、Snowflake ターゲットにレプリケートし、 [ロード方法] が Snowpipe streaming に設定されている場合、適用モードは常にトランザクションであるため、設定できません。
-
トランザクションごとの最小変更数: 各トランザクションに含める変更の最小数。既定値は 1000 です。
情報メモレプリケーション タスク は、変更の数がトランザクションごとの最小変更数以上の場合、またはバッチ タイムアウト値 (下記を参照) に達した場合の、いずれかの先に発生したほうのタイミングでターゲットに変更を適用します。ターゲットに適用される変更の頻度はこれら 2 つのパラメーターによって制御されるため、ソース レコードへの変更がターゲット レコードにすぐに反映されない場合があります。 - 適用前にトランザクションをバッチ処理する最大時間 (秒): タイムアウトを宣言するまでにトランザクションをバッチで収集する最大時間。既定値は 1 です。
スキーマの自動進化
スキーマ内の次のタイプの DDL 変更を処理する方法を選択します。スキーマの進化の設定を変更した場合は、再度タスクを準備する必要があります。次の表には、サポートされている DDL 変更に対して使用できるアクションが示されています。
| DDL の変更 | ターゲットに適用 | 無視 | テーブルを一時停止 | タスクを停止 |
|---|---|---|---|---|
| 列を追加 | 可 | 可 | 可 | 可 |
| 列のデータ型を変更 | 可 | 可 | 可 | 可 |
| 列名を変更 | 可 | 不可 | 可 | 可 |
|
テーブルの名前を変更 情報メモKafka がターゲット プラットフォームの場合はサポートされません。
|
不可 | 不可 | 可 | 可 |
| 列をドロップ | 可 | 可 | 可 | 可 |
|
テーブルをドロップ 情報メモKafka がターゲット プラットフォームの場合はサポートされません。
|
可 | 可 | 可 | 可 |
| テーブルを作成
[選択ルール] を使用してパターンに一致するデータセットを追加した場合、パターンを満たす新しいテーブルが検出され、追加されます。 |
可 | 可 | 不可 | 不可 |
文字置換
ターゲット データベース内のソース文字の置換または削除、および/または選択した文字セットでサポートされていないソース文字の置換または削除ができます。
-
文字はすべて Unicode コード ポイントとして指定する必要があります。
- 文字置換は、 コントロール テーブルでも実行されます。
-
無効な値は、テーブルのセルの右上に赤い三角形で示されます。三角形の上にマウス カーソルを置くと、エラー メッセージが表示されます。
-
タスクに定義されたテーブルレベルまたはグローバル変換は、文字の置換が完了した後に実行されます。
-
[ソース文字の置換または削除] テーブルで定義された置換アクションは、 [選択した文字セットでサポートされていないソース文字の置換または削除] テーブルで定義された置換アクションの前に実行されます。
- 文字置換は LOB データ型をサポートしません。
ソース文字の置換または削除
[ソース文字の置換または削除] テーブルを使用して、特定のソース文字の置換を定義します。これは、文字の Unicode 表現がソース プラットフォームとターゲット プラットフォームで異なる場合などに便利です。たとえば、Linux では、Shift_JIS 文字セットのマイナス文字は U+2212 と表されますが、Windows では U+FF0D と表されます。
| 内容 | 実行すること |
|---|---|
|
置換アクションを定義する。 |
|
|
指定されたソースまたはターゲットの文字を編集する |
行の最後にある |
|
テーブルからエントリを削除する |
行の最後にある |
 をクリックして、 [
選択した文字セットでサポートされていないソース文字の置換または削除
[文字セットでサポートされていないソース文字] テーブルを使用して、選択した文字セットでサポートされていないすべての文字に対して 1 つの置換文字を定義します。
| 内容 | 実行すること |
|---|---|
|
置換アクションを定義または編集する。 |
|
|
置換アクションを無効にする。 |
[文字セット] ドロップダウン リストから空のエントリを選択します。 |
詳細オプション
これらのオプションは特定のバージョンまたは環境にのみ関連するため、UI では公開されていません。したがって、Qlik サポートまたは製品ドキュメントにより明示的に指示されない限り、これらのオプションを設定しないでください。
オプションを設定するには、オプションを [機能名の追加] 項目にコピーし、 [追加] をクリックします。次に、受け取った指示に従って値を設定するか、オプションを有効にします。
データセット セグメントの並列ロード
フル ロード中は、データセットをセグメントに分割して並列でロードすることで、大規模なデータセットのロードを高速化できます。テーブルは、データ範囲、すべてのパーティション、すべてのサブパーティション、または特定のパーティションごとに分割できます。
詳細は、並列のレプリケート データセット セグメントをご覧ください。
タスクのスケジューリング
場合によっては、データ ソースからターゲット プラットフォームに変更を伝達するために、タスクをスケジュールする必要がある場合があります。
詳細は、Scheduling tasksをご覧ください。