跳到主要内容 跳到补充内容

编辑已转换的作业

上次更新日期:2025/10/12

更新组件以完成在 Spark Streaming 框架中运行的数据转换流程。

使用 Kafka 集群而非 DBFS 系统,将流式处理影片数据提供给作业。在查找流中,仍然从 DBFS 提取导演数据。

开始之前

  • 要使用的 Databricks 集群已正确配置,并且正在运行。

  • 集群管理员已经为用户名提供读取/写入权限,使其能够访问 DBFS 和 Azure ADLS Gen2 存储系统中的相关数据和目录。

步骤

  1. 在 Repository (存储库) 中,双击 aggregate_movie_director_spark_streaming 作业以在工作区中将其打开。

    图标表示当前的作业框架 Spark Batch 中不存在原始作业中所用的组件。在本示例中,是 tHDFSInput 和 tHDFSOutput。

  2. 单击 tHDFSInput 将其选中,然后在弹出的 Warning (警告) 窗口中单击 OK (确定) 关闭此窗口。
  3. 按下键盘上的 Delete (删除) 以移除 tHDFSInput。
  4. 在作业工作区中输入 tFileInputDelimited,然后从显示的列表中选择此组件。

    tFileInputDelimited 将添加到工作区。

  5. 执行相同的操作,将 tHDFSOutput 替换为 tFileOutputDelimited。
  6. 展开 Repository (存储库) 中 Metadata (元数据) 节点下的 Hadoop cluster (Hadoop 集群),然后展开 my_cdh 连接节点及其子节点,以显示在 HDFS 文件夹下设置的 movies (影片) schema 元数据节点。
  7. 将此 schema 元数据节点拖放到作业工作区中的新 tFileInputDelimited 组件上。
  8. 右键单击此 tFileInputDelimited 组件,然后从上下文菜单中选择 Row (行) > Main (主) 并单击 tMap 将其连接到 tMap。
  9. 右键单击 tMap,然后从上下文菜单中选择 Row (行) > out1 并单击新的 tFileOutputDelimited 将 tMap 连接到此组件。
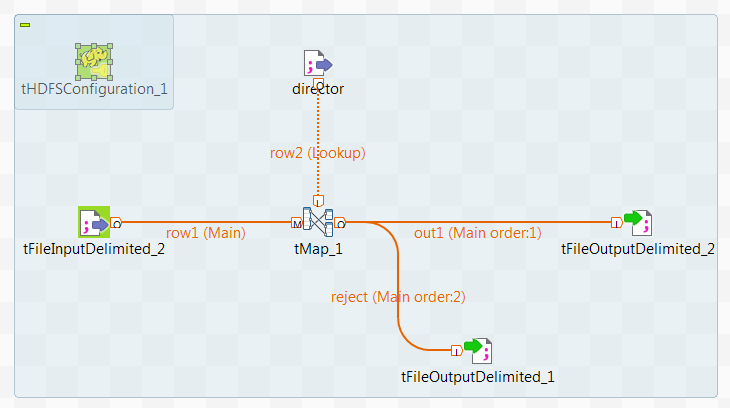
  10. 双击新的 tFileOutputDelimited 组件打开其 Component (组件) 视图。
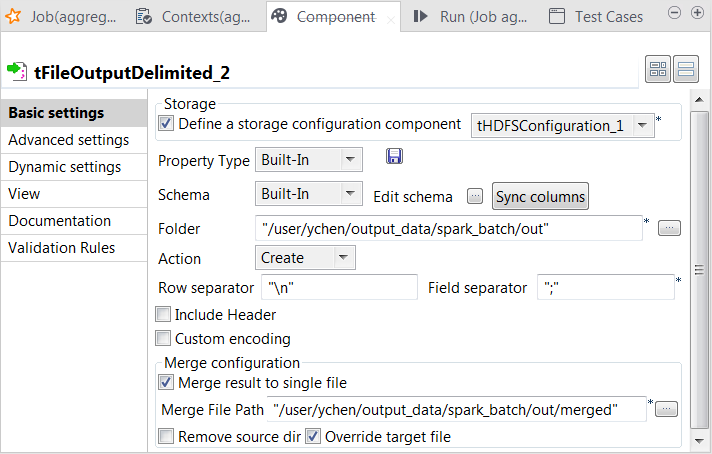
  11. 在 Folder (文件夹) 字段中,输入或浏览到需要写入结果的目录。在本场景中,为 /user/ychen/output_data/spark_batch/out,其接收包含影片导演姓名的记录。
  12. 选中 Merge result to single file (将结果合并到单个文件) 复选框,以便将通常由 Spark 生成的 part- 文件合并到一个文件中。

    此时 Merge file path (合并文件路径) 字段将显示。

  13. 在 Merge file path (合并文件路径) 字段中,输入或浏览到 part-part- 文件要合并到的文件。

    在本场景中,此文件为 /user/ychen/output_data/spark_batch/out/merged。

  14. 双击另一个从 tMap 接收 reject (拒绝) 连接的 tFileOutputDelimited 组件,打开其 Component (组件) 视图。
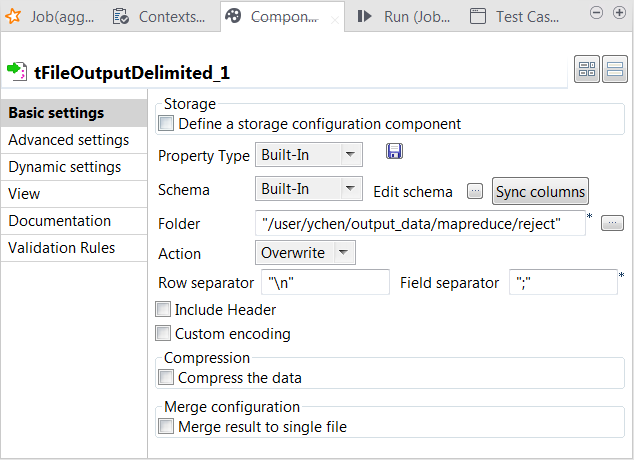
  15. 在 Folder (文件夹) 字段中,将目录设定为 /user/ychen/output_data/spark_batch/reject。
  16. 在 Run (运行) 视图中,单击 Spark configuration (Spark 配置) 选项卡以验证是否已从原始作业正确继承 Hadoop/Spark 连接元数据。
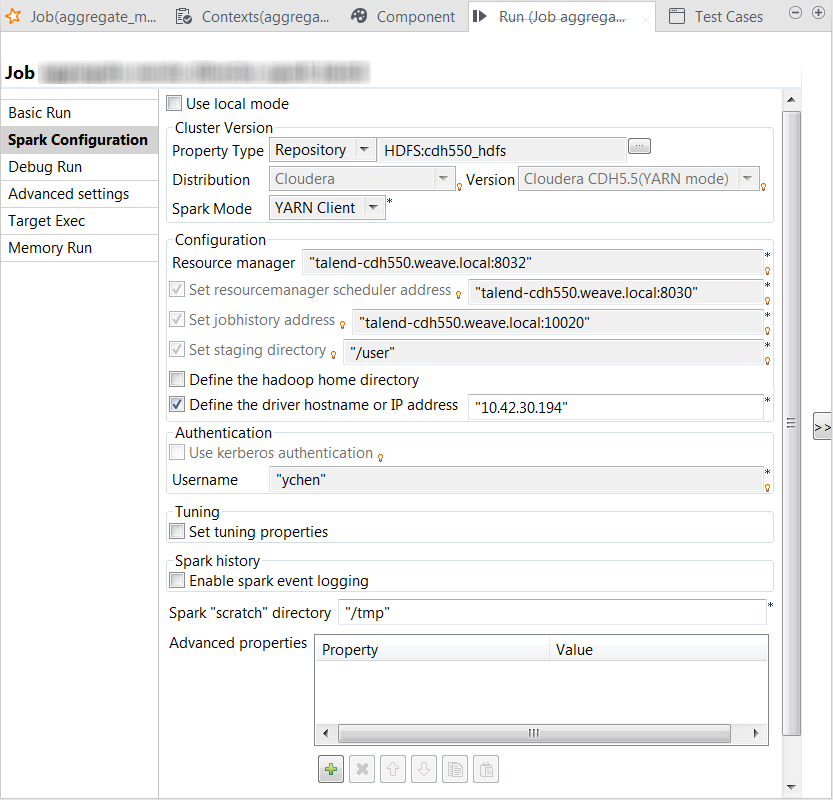
    您始终需要使用此 Spark Configuration (Spark 配置) 选项卡为整个 Spark Batch 作业定义与给定 Hadoop/Spark 发行版的连接,此连接在作业范围内生效。

  17. 如果您不确定 Spark 集群是否能够解析执行作业的计算机的主机名,选中 Define the driver hostname or IP address (定义驱动程序主机名或 IP 地址) 复选框,然后在显示的字段中输入此计算机的 IP 地址。

    如不勾选此复选框,Spark 集群会将在地址为 127.0.0.1 的计算机 (即集群内的这台计算机本身)上查找 Spark 驱动程序。

  18. 按 F6 运行作业。

结果

Run (运行) 视图将在 Studio 的下半部分自动打开,并显示此作业的执行进度。

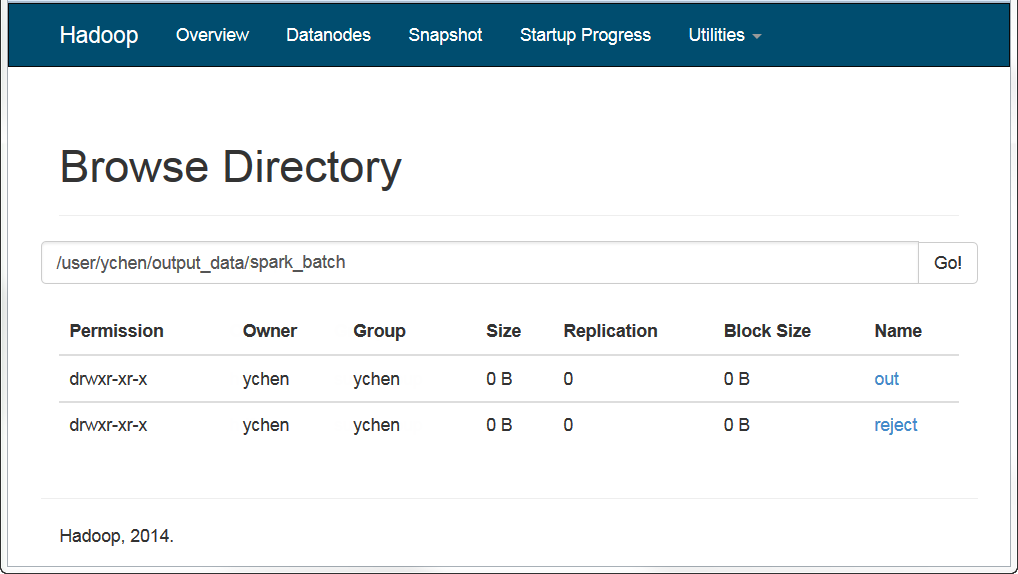
完成后,您可以检查 (例如在 HDFS 系统的 Web 控制台中) 输出是否已被写入了 HDFS 中。
本页面有帮助吗?

如果您发现此页面或其内容有任何问题 – 打字错误、遗漏步骤或技术错误 – 请告诉我们!