# 複寫設定

您可為資料複寫任務進行設定。

* 開啟複寫任務並在工具列中按一下設定。

就會開啟 設定：&lt;Task-Name&gt; 對話方塊。可用設定如下所述。

## 一般

在此索引標籤中，您可以變更複寫模式、暫存設定 (如可用)、將變更套用至目標的模式，以及發佈設定。

### 複寫模式

有下列複寫模式可用：

* 完整載入： 將資料從所選來源表格載入到目標平台，並建立目標表格 (如有必要)。完整載入會在任務開始時自動發生，但如有需要，也可以手動執行。例如，如果您需要將更新複寫到檢視 (未在 CDC 期間擷取) 或您正在從不支援 CDC 的資料來源複寫，則需要手動完整載入。

  資訊備註使用 SaaS 應用程式連接器時，此選項將始終啟用，因為需要完整載入。

* 套用變更： 以對來源表格所做的任何變更更新目標表格。

* 儲存變更： 在變更表格 (每個來源表格一個) 中將變更儲存至來源表格。

  如需詳細資訊，請參閱[儲存變更](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm#Store)。

使用 資料移動閘道 時，除了使用 SaaS 應用程式來源之外，會幾乎即時地從來源擷取變更。在沒有 資料移動閘道 的情況下工作時 (例如透過 Qlik Talend Cloud 啟動器 訂閱或選取 無 時) 或使用 SaaS 應用程式來源時，會根據排程器設定擷取變更。如需詳細資訊，請參閱 [Scheduling tasks](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Deploying/Scheduling-tasks.htm)。

資訊備註

如果您選取 儲存變更 或 套用變更，且您的資料來源：

* 不是 SaaS 應用程式

* 包含支援 CDC 的資料集，以及僅支援完整載入的資料集 (例如檢視表)

將會建立兩個資料管線。將為支援 CDC 的資料表建立一個管道，並為僅支援完整載入的資料集建立另一個管道。

### 載入方法

複寫到 Snowflake 時，您可以選擇以下載入方法之一：

* 批次載入 (預設)

  如果選取批次載入，您將能夠在資料上傳索引標籤中調整載入參數。

* Snowpipe 串流

  資訊備註

  只有在滿足以下條件時，才可選取 Snowpipe 串流：

  * 已啟用儲存變更複寫模式，而沒有套用變更。
  * Snowflake 連接器中的驗證機制 設定為金鑰組。
  * 如果您使用 資料移動閘道，則需要版本 2024.11.45 或更高版本。

  如果您選取 Snowpipe 串流，請確保您熟悉使用此方法時的[限制和考慮事項](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/snowflake-target.htm#Limitati2)。此外，如果您選取 Snowpipe 串流，然後啟用套用變更複寫模式或停用儲存變更，則載入方法將自動切換回批次載入。

選擇 Snowpipe 串流而不是批次載入的主要原因是：

* 成本較低：由於 Snowpipe 串流不使用 Snowflake 倉庫，因此操作成本應該會便宜許多，不過這取決於您的具體使用情況。

* 減少延遲：由於資料直接串流到目標表格 (而不是透過暫存)，從資料來源複寫到目標的速度應該會更快。

提示備註使用 Snowpipe 串流時，初始完整載入可能比批次載入慢很多。為了最佳化載入效能，尤其是在載入大型資料集時，最佳做法是將 Snowpipe 串流與[平行載入功能](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/Table-settings-replication.htm)搭配使用。

### 連線至暫存區域

複寫至下列資料倉庫時，您需要設定暫存區域。會先在暫存區域中處理並準備資料，再傳輸至倉庫。

* [Amazon Redshift](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/redshift-target.htm)
* [Microsoft Fabric](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/fabric-target.htm)
* [Databricks](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/databricks-target.htm)

選取現有的暫存區域，或按一下新建以定義新的暫存區域，並按照 [連線至雲端儲存空間](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/cloud-storage-connections.htm) 中的說明。

若要編輯連線設定，按一下編輯。若要測試連線 (建議)，按一下測試連線。

如需資料倉庫支援哪些暫存區域的資訊，請參閱 中的作為暫存區域受到支援[目標平台使用案例和支援版本](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/data-project-connections.htm#ar_app_supported_dbversions_993761142_cjaehbcc)欄。

### 套用變更模式

資訊備註複寫至資料倉庫目標或使用 Qlik Talend Cloud 啟動器 訂閱時，您無法選取要使用哪個套用變更模式。變更永遠會在批次最佳化模式下套用，以提供最大效率。對此的例外情況是複寫到 Snowflake 目標且載入方法 設定為 Snowpipe 串流時。在這種情況下，雖然您仍然無法選取要使用哪一種套用變更模式，但變更將一律在交易模式下套用。

變更會使用下列方法之一套用至目標表格：

* 批次最佳化：此為預設。若選取此選項，會在批次中套用變更。會發生前置處理動作，以最有效率的方式將交易組成批次。
* 交易：選取此選項以認可順序個別套用每筆交易。在此情況下，會為所有表格確保嚴格參考完整性。

### 發佈設定

* 發佈至目錄

  選取此選項以將此資料版本發佈至目錄作為資料集。將會在下次您準備此任務時更新目錄內容。

  如需更多關於目錄的資訊，請參閱 [使用目錄工具理解資料](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/Catalog/catalog-overview.htm)。

### 使用 資料移動閘道 時的 Proxy 設定

* 使用 Data Movement gateway 時，請透過 Proxy 連線至

  使用 資料移動閘道 時，您可以透過 Proxy 連線至目標平台和暫存平台 (區域)。

  如需有關設定 資料移動閘道 以使用 Proxy 伺服器的詳細資訊，請參閱 [設定 Qlik Cloud 租用戶和 Proxy 伺服器](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/Gateways/dm-gateway-setting-up.htm#Setting)。

  * 使用資料移動閘道時的 Proxy 伺服器

    選取此選項以使用為 資料移動閘道 設定的 Proxy 伺服器。

  * 目標平台

    資訊備註使用 Snowflake 和 Databricks 時可用。

  * 預備平台

    資訊備註使用 Google BigQuery、Amazon Redshift、Microsoft Fabric 和 Databricks 時可用。

## 資料上傳

只有在複寫至資料倉庫或 Kafka 目標時，才會顯示此索引標籤。此外，此索引標籤中的設定將會根據選取的目標而有所不同。

###

### 與所有資料倉庫目標相關

檔案大小上限

檔案在關閉之前可達到的大小上限。較小的檔案可能上傳得更快 (取決於網路)，並且可在結合平行執行選項使用時改善效能。不過，以小檔案叢集資料庫通常被視為不良做法。

### 僅與 Snowflake 目標相關

在一般索引標籤中，您可以選取要使用批次載入或 Snowpipe 串流將資料載入到 Snowflake。若選取 Snowpipe 串流，將不會顯示資料上傳索引標籤。若選取批次載入，將可使用以下設定：

* 檔案大小上限 (MB)： 適用於初始完整載入與 CDC。檔案在載入至目標之前可達到的大小上限。如您遇到效能問題，請嘗試調整此參數。

* 每個批次載入的檔案數量： 僅適用於初始完整載入。要以單一批次載入的檔案數量。如您遇到效能問題，請嘗試調整此參數。

如需批次載入和 Snowpipe 串流載入方法的描述，請參閱 [一般](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm#General)。

### 僅與 Teradata 目標相關

當 Teradata 為目標時，請在複寫工作中配置這些設定。

#### 基本設定

* TPT 運算子：選取 Load 或 Stream。預設為 串流。
* JSON 格式：選取 文字、BSON 或 UBJSON。預設為 文字。

#### TPT 運算子模式

TPT 運算子決定資料如何寫入 Teradata。

* Stream（預設）：使用 Teradata TPump 通訊協定進行近乎即時的高速 DML 交易。在進行 DML 作業時，仍可查詢資料表。此模式對持續變更處理的限制較少。當來源支援此運算子時，資料庫使用者可能也需要 `CREATE MACRO` 權限。

* 載入：使用 Teradata FastLoad 通訊協定將大量資料載入至空資料表中。目標資料表必須為空，且不能有次要索引。僅在這些限制符合任務的處理需求時才使用此模式。

#### JSON 格式選項

指定 JSON 資料欄在 Teradata 中的儲存方式：

* 文字（預設）：將 JSON 資料儲存為文字。
* BSON：以 BSON 格式儲存 JSON 資料。
* UBJSON：以 UBJSON 格式儲存 JSON 資料。

#### 進階 TPT 屬性

在 TPT 屬性下，設定下列選項：

* 緩衝區大小：設定用於將載入封包傳送至 Teradata 的輸出緩衝區大小。輸入 1 到 64 KB 之間的值。
* 緩衝區：設定所使用的請求緩衝區數量。請輸入 2 或更高的值。
* 明確工作階段範圍：設定可登入 Teradata 的工作階段數量下限及/或上限。
  * 最大值：設定工作階段的最大數量。該值不能超過可用存取模組處理器 (AMP) 的數量。
  * 最小值：設定工作階段數量的下限。
* 動態陳述式封裝：選取此選項可讓串流驅動程式決定目前串流工作的最大可能封裝。
* 陳述式打包：設定在 Stream 模式下打包至多重陳述式請求中的陳述式數量。請輸入 2 至 600 之間的值。未選取 動態陳述式封裝 時，即可使用此選項。

### 僅與 Kafka 目標相關

#### 訊息屬性

壓縮

選擇性地選取其中一個可用的壓縮方法 (Snappy 或 Gzip)。預設為無。

#### 資料訊息發佈

選擇下列其中一個將資料發佈至選項：

* 特定主題： 將資料發布至單一主題。輸入主題名稱，或使用瀏覽按鈕選取所需主題。

* 每個資料表的個別主題：將資料發布至與來源資料表名稱相對應的多個主題。

  目標 topic 名稱由來源結構描述名稱和來源資料表名稱組成，並以句點分隔 (例如，dbo.Employees)。目標 topic 名稱的格式很重要，因為您需要事先準備這些 topic。

資訊備註

如果主題不存在，請使用 `auto.create.topics.enable=true` 設定代理程式，以讓資料任務在執行階段建立主題。否則，任務將會失敗。

如需在資料集層級覆寫此設定的資訊，請參閱 [發佈至 Kafka 時覆寫個別資料集的任務設定](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/kafka-dataset-settings.htm)

訊息索引鍵

選取其中一個可用選項。

* 主鍵欄位：針對每則訊息，訊息鍵將包含主鍵欄位的值。

  當依訊息金鑰被選為分割策略時，由相同主鍵值組成的訊息將寫入相同的分割區。

* 結構描述和表格名稱： 對於每個訊息，訊息金鑰將包含結構描述和表格名稱的組合（例如，dbo+Employees）。

  當依訊息金鑰被選為分割策略時，由相同結構描述和表格名稱組成的訊息將寫入相同的分割區。

* 無：建立不含訊息索引鍵的訊息。

如需在資料集層級覆寫此設定的資訊，請參閱 [發佈至 Kafka 時覆寫個別資料集的任務設定](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/kafka-dataset-settings.htm)

分割策略

選取 隨機 或 依訊息金鑰。如果您選取 隨機，每個訊息將寫入隨機選取的分割區。如果您選取 依訊息金鑰，訊息將根據選取的 訊息金鑰 (如上所述) 寫入分割區。

#### 中繼資料訊息發佈

資訊備註使用 JSON 訊息格式時，不需要發佈資料結構描述。

主旨名稱策略

資訊備註

第一個策略 (結構描述和表格名稱) 是一種專有的 Qlik 策略，而其他三個是標準的 Confluent 主題名稱策略。

選取其中一個可用的主題名稱策略。

* 結構描述和表格名稱 (預設)
* 主題名稱
* 記錄名稱
* 主題和記錄名稱

如需 Confluent 主題名稱策略的詳細資訊，請參閱 [主題名稱策略](https://docs.confluent.io/platform/current/schema-registry/serdes-develop/index.html#subject-name-strategy)

主旨相容性模式

從 主題相容性模式 下拉式清單中選取下列其中一個相容性模式：

* 使用 Schema Registry 預設值：從 Schema Registry 伺服器設定擷取相容性層級。

* 向下相容 - 僅限最新結構描述：新結構描述僅能讀取對應的資料，以及由最新註冊之結構描述所產生的資料。

* 遞移向下相容 - 所有先前的結構描述： 新的結構描述可以讀取由所有先前註冊的結構描述所產生的資料。

* Forward - 僅最新結構描述： 最新註冊的結構描述可讀取由新結構描述產生的資料。

* 向前可傳遞 - 所有先前的結構描述： 所有先前註冊的結構描述都可以讀取由新結構描述所產生的資料。

* 完整 - 僅限最新結構描述：新結構描述與最新註冊的結構描述向後及向前相容。

* 完全可傳遞 - 所有先前的結構描述： 新的結構描述與所有先前註冊的結構描述回溯相容且向前相容。

* 無

資訊備註

* 根據所選的主體名稱策略，某些相容性模式可能無法使用。

* 將訊息發佈到結構描述登錄時，所有新建立的*控制表主體*的預設主體相容性模式將為無，無論所選的主體相容性模式為何。

  如果您希望所選的主體相容性模式也適用於控制表，請將 Kafka 目標連接器中的setNonCompatibilityForControlTables內部參數設定為false。

使用 Proxy 連線至 Confluent 結構描述登錄

資訊備註

此選項僅支援發佈至 Confluent Schema Registry 時使用。

如果您的 資料移動閘道 已設定為使用代理伺服器，則開啟。

#### 訊息屬性

您可以指定將會覆寫預設訊息屬性的自訂訊息屬性。如果取用端應用程式需要以特定格式處理訊息，這會很有用。

自訂訊息屬性可以在任務和資料表層級定義。當屬性在任務 *和* 資料表層級都定義時，為資料表定義的訊息屬性將會優先於為任務定義的屬性。

如需覆寫資料集層級的訊息屬性，請參閱 [發佈至 Kafka 時覆寫個別資料集的任務設定](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/kafka-dataset-settings.htm)

資訊備註

不支援階層式結構訊息。

一般規則與使用準則

定義自訂訊息時，務必考量下列規則與使用準則。

區段名稱

下列命名規則適用：

* 區段名稱必須以字元 a-z、A-Z 或 \_ (底線) 開頭，然後可以追蹤下列任何字元：a-z、A-Z、0-9、\_

* 除了 記錄名稱 和 金鑰名稱區段 (不以斜線結尾) 之外，從區段名稱中移除斜線將會扁平化相關聯區段的階層 (請參閱下方的 斜線)。

* 除了 記錄名稱 和 金鑰名稱 之外，所有區段名稱都可以刪除 (請參閱下方的 刪除)

* 資料名稱 和 包含記錄前資料 區段名稱不能同時刪除

* 「資料名稱」和「包含記錄前資料」區段名稱不能相同

[](https://help.qlik.com/en-US/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm)斜線

UI 中的部分區段名稱以斜線結尾 (例如`beforeData/`). 斜線的目的是維護訊息中不同區段的階層。如果移除斜線，將會發生下列情況：

* 該區段的階層結構將會扁平化，導致區段名稱從訊息中移除
* 區段名稱將會作為實際中繼資料的前綴，可以直接使用，也可以使用您附加到名稱的分隔字元 (例如底線)

當`headers/`以斜線指定時的資料訊息範例：

```
		"message":{
		        "data":{
			      "COL1": "159",
			      "COL2": "159"
                       },
                       "beforeData": null,
		        "headers": {
			"operation": "INSERT",
			"changeSequence": "2018100811484900000000233",
```

當`headers_`以底線而非斜線指定時的資料訊息範例：

```
		"message":{
		        "data":{
			      "COL1": "159",
			      "COL2": "159"
                       },
                       "beforeData": null,                     
                       "headers_operation": "INSERT",
			"headers_changeSequence": "2018100811484900000000233",
```

[](https://help.qlik.com/en-US/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm)刪除

從訊息中刪除區段名稱將會扁平化該區段的階層結構。這會導致該區段的所有資料立即顯示在前面區段的內容下方。

包含` headers  `區段名稱的資料訊息範例：

```
	        "message":{
		        "data":{
			      "COL1": "159",
			      "COL2": "159"
                       },
		        "headers": {
			"operation": "INSERT",
			"changeSequence": "2018100811484900000000233",
```

不含` headers  `區段名稱的資料訊息範例：

```
	        "message":{
		        "data":{
			      "COL1": "159",
			      "COL2": "159"
                       },
                       "beforeData": null,                   
                       "operation": "INSERT",
			"changeSequence": "2018100811484900000000233",
```

變數

您可以按一下資料列結尾的![](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Resources/Images/Replicate/fx_icon_12x14.png)按鈕，將變數新增至名稱。以下變數可供使用：

* SERVER\_NAME - 資料移動閘道伺服器的主機名稱
* TARGET\_TABLE\_NAME - 資料表的名稱
* TARGET\_TABLE\_OWNER - 資料表擁有者
* TASK\_NAME - 資料任務的名稱

資訊備註

TARGET\_TABLE\_OWNER 變數不適用於記錄名稱和索引鍵名稱選項 (如下表所述)。

定義自訂訊息屬性

若要定義自訂訊息格式，請開啟使用自訂設定，並依照下表所述設定選項。

若要還原為預設訊息屬性，請關閉使用自訂設定。

訊息格式選項

| 選項 | 描述 |
| --- | --- |
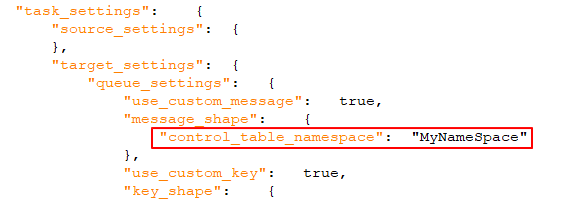
| [](https://help.qlik.com/en-US/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm)包括命名空間 | 開啟時 (預設)，訊息中將包含一個唯一識別碼。這應該是以句點分隔的字串。請注意，命名空間將會包括在訊息和訊息索引鍵中。<br><br>範例：<br><br>mycompany.queue.msg<br><br>預設名稱：<br><br>com.attunity.queue.msg.{{TASK\_NAME}}.{{TARGET\_TABLE\_OWNER}}.{{TARGET\_TABLE\_NAME}}<br><br>控制表的預設名稱：<br><br>com.attunity.queue.msg.{{TARGET\_TABLE\_NAME}}<br><br>資訊備註<br><br>預設的控制表命名空間無法透過 UI 變更。不過，您可以依照下列方式變更預設的控制表命名空間：<br><br><ol> <li>在「任務設定」的 <span>訊息格式</span> 索引標籤中，按一下 <span>自訂訊息格式</span> 按鈕，然後按一下 <span>確定</span>。</li> <li>儲存任務，然後使用 <span>匯出任務</span> 工具列按鈕匯出。</li> <li> <p>開啟匯出的 JSON 檔案，並新增<code>control_table_namespace</code>參數，如下所示 (將<code>MyNameSpace</code>替換為您自己的值)：</p> <p> <img src="https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Resources/Images/Replicate/kafka_json.png" alt="已醒目提示「control_table_namespace」欄位的 JSON 檔案匯出範例"> </p> </li> <li>儲存 JSON 檔案，然後使用<span>匯入任務</span>工具列按鈕將其匯入 Replicate。</li> </ol> |
| 記錄名稱 | 記錄 (訊息) 的名稱。<br><br>預設名稱：<br><br>DataRecord |
| 資料名稱 | 記錄中包含的所有資料欄。<br><br>預設名稱：<br><br>資料/ |
| 包括標頭 | 開啟時 (預設值)，標頭欄將包含在訊息中。標頭欄提供關於來源作業的額外資訊。<br><br>如需詳細資訊，請參閱下方包含下列標頭。 |
| 包括標頭命名空間 | 開啟時 (預設值)，訊息中將會包含標頭欄區段的唯一識別碼。這應該是以句點分隔的字串。<br><br>範例：<br><br>headers.queue.msg<br><br>預設名稱：<br><br>com.attunity.queue.msg |
| 標頭名稱 | 包含 Qlik 欄標頭的區段名稱。<br><br>預設名稱：<br><br>標頭/ |
| [](https://help.qlik.com/en-US/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm)包括訊息標頭 | 如需可用標頭欄的說明，請參閱 Qlik 說明中的 資料訊息。<br><br>預設：<br><br>依預設會包含所有欄，但 外部結構描述 ID 欄除外。 |
| 包括記錄之前資料 | 啟用時 (預設)，更新前和更新後的資料都將會包含在更新訊息中。<br><br>若要只在訊息中包含更新後的資料，請關閉此選項。<br><br>預設名稱：<br><br>之前的資料/ |
| 索引鍵名稱 | 包含訊息金鑰的區段名稱。<br><br>預設名稱：<br><br>keyRecord<br><br>此選項僅適用於以下情況：<br><br><ul> <li>訊息格式為<span>Avro</span>。</li> <li><span>中繼資料發佈方法</span>設定為<span>將資料結構描述發佈至 Confluent Registry Schema</span>或<span>將資料結構描述發佈至 Hortonworks Schema Registry</span></li> <li><span>訊息金鑰</span>未設定為<span>無</span></li> </ul> |

#### 其他設定

* 訊息最大大小

  在訊息最大大小欄位中，指定代理程式設定為接收的訊息最大大小(`message.max.bytes`)。資料任務將不會傳送大於最大大小的訊息。

## 中繼資料

### 基本

* 目標表格結構描述

  目標上的結構描述，若您不想使用來源表格結構描述 (或者若來源資料庫中沒有結構描述)，來源表格將會複寫到這裡。

  資訊備註複寫至 Oracle 目標時，預設目標表格結構描述為「系統」。也請注意，若您讓此欄位空白 (在此情況下，將會使用來源結構描述)，您必須確認來源結構描述已存在於目標。否則，任務將會失敗。

  資訊備註許可的結構描述名稱長度上限為 128 個字元。

#### JSON 欄對應

將相容的來源 JSON 欄對應至目標的 JSON 欄

資訊備註

* 若您使用 資料移動閘道 存取資料來源，則需要版本 2024.11.70 或更高版本。

選取此選項時，來源上的 JSON 欄位將自動對應至目標上的 JSON 欄位。

此選項的狀態和可見性由下列因素決定：

* 新任務： 如果來源和目標都支援 JSON 資料類型，此選項將預設啟用。

* 現有任務： 此選項預設為停用，即使來源和目標都支援 JSON 資料類型。這是為了保留與下游程序（例如轉換）的向下相容性，這些程序預期目標資料為字串格式（這是舊版行為）。您可以停用該選項，也可以編輯下游流程，使之相容於 JSON 格式，然後啟用此選項。

* 新增和現有任務： 如果只有來源支援 JSON 資料類型，此選項將不可見。如果稍後階段將 JSON 支援新增至目標，該選項將會顯示但保持停用。這是為了保留與下游程序（例如轉換）的向下相容性，這些程序預期目標資料為字串格式（這是舊版行為）。

#### LOB 設定

資訊備註這些設定不適用於使用 SaaS 應用程式連接器的任務。

可用 LOB 設定根據所選複寫目標而異。資料倉庫目標不支援無限 LOB 欄大小，此選項在複寫至資料倉庫時無法使用。

不是資料倉庫之目標的 LOB 設定

* 請勿納入 LOB 欄：若您不想複寫來源 LOB 欄，則選取此項。

* 將 LOB 欄大小限制為 (KB)：此為預設。若您只需要複寫小型 LOB，或者若目標平台不支援無限的 LOB 大小，則選取此選項。對此欄位許可的值上限為 102400 KB (100 MB)。

  複寫小型 LOB 時，此選項比請勿限制 LOB 欄大小選項更有效率，因為 LOB 是「內嵌」複寫，與透過從來源「查詢」不同。在變更處理期間，通常會透過從來源「查詢」複寫小型 LOB。

  此限制適用於從來源端點讀取的 LOB 位元組數量。對於 BLOB 欄，目標 BLOB 大小將完全符合指定的限制。對於 CLOB 和 NCLOB 欄，如果來源和目標 LOB 沒有相同的字元集，則目標 LOB 大小可能與指定的限制不同。在這種情況下，資料任務將執行字元集轉換，這可能會導致來源和目標 LOB 大小之間存在差異。

  由於限制 LOB 大小的值以位元組為單位，應根據下列公式計算大小：

  * BLOB：最大 LOB 的長度。
  * NCLOB：最長文字長度的字元數乘以二 (因為每個字元視為雙位元組來處理)。若資料包括 4 位元組字元，則乘以四。
  * CLOB：最長文字長度的字元數 (因為每個字元視為 UTF8 字元來處理)。若資料包括 4 位元組字元，則乘以二。

  資訊備註

  * 將會截斷任何大於指定大小的 LOB。
  * 從 Oracle 來源變更處理期間，會內嵌複寫內嵌 BLOB。
  * 對此設定的變更只會在載入之後影響現有表格。

* 不限制 LOB 欄位大小：選取此選項時，無論大小為何，都會複寫 LOB 欄位。

  資訊備註複寫 LOB 欄可能會影響效能。若大型 LOB 欄需要複寫任務從來源表格執行查詢以便擷取來源 LOB 值，尤其如此。

  * 當 LOB 大小少於以下值時最佳化：當您需要同時複寫小型與大型 LOB，且大部分 LOB 均為小型時，請選取此選項。

    資訊備註

    僅下列來源和目標支援此選項：

    * **來源：** Oracle、Microsoft SQL server、MySQL、PostgreSQL 以及 IBM DB2 for LUW

    * **目標：** Oracle、Microsoft SQL Server、MySQL、PostgreSQL。

    若選取此選項，則在完整載入期間，將會「內嵌」複寫小型 LOB (這更有效率)，而大型 LOB 的複寫方式則是從來源表格執行查詢。不過，在變更處理期間，小型和大型 LOB 的複寫方式都是從來源表格執行查詢。

    資訊備註

    若選取此選項，複寫任務將會檢查所有 LOB 大小，以決定哪些是「內嵌」傳輸。將會使用完整 LOB 模式複寫大於指定大小的 LOB。

    因此，如果您知道大部分的 LOB 都大於指定的設定，建議改為使用 **Replicate 無限制 LOB 欄位** 選項。

  * 區塊大小 (KB)：可以選擇變更 LOB 區塊大小，以在將資料複寫到目標時使用。預設區塊大小在大部分的情況下應該都足夠，但如果您遇到效能問題，調整大小可能會改善效能。

    資訊備註

    透過某些資料庫，插入或更新資料時會發生資料類型驗證。在這種情況下，結構化資料類型的複寫 (例如XML、JSON、GEOGRAPHY 等)，若資料大於指定的區塊大小可能會失敗。

支援的資料倉庫目標的 LOB 設定

* 納入 LOB 欄並將欄大小限制為 (KB)：

  您可選擇在任務中納入 LOB 欄，以及設定最大 LOB 大小。將會截斷大於最大大小的 LOB。

### 進階

#### 控制表格設定

* 控制資料表結構描述：如果您不希望在來源結構描述 (預設值) 或目標結構描述中建立控制資料表，請指定控制資料表的目標結構描述。

  資訊備註許可的結構描述名稱長度上限為 128 個字元。

* 在表格空間中建立目標控制表格：​若複寫目標是 Oracle，請指定您要建立目標控制表格的表格空間。若您沒有在此欄位中輸入任何資訊，將會在目標資料庫的預設表格空間中建立表格。

* 為表格空間中的目標控制表格建立索引：若複寫目標是 Oracle，請指定您要建立控制表格索引的表格空間。若您沒有在此欄位中輸入任何資訊，將會在與控制表格相同的表格空間中建立索引。

* 複寫歷程記錄時間區段 (分鐘)：[複寫歷史記錄](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replication_history.htm) 控制資料表中每個時間區段的長度。預設為 5 分鐘。

#### 控制表格選項

選取您要在目標平台建立的控制表格：

| 邏輯名稱 | 目標中的名稱 |
| --- | --- |
| 套用例外情況 | attrep\_apply\_exceptions |
| 複寫狀態 | attrep\_status |
| 暫停的表格 | attrep\_suspended\_tables |
| 複寫歷史記錄 | attrep\_history |
| DDL 歷史記錄 | attrep\_ddl\_history<br><br>僅下列目標平台支援 DDL 歷史記錄表格：<br><br><ul> <li> <p>Databricks</p> </li> <li>Microsoft Fabric</li> <li>Amazon Redshift</li> <li>如果您正在使用 <span>資料移動閘道</span>，則以下目標需要版本 2024.11.14 或更高版本：<ul><li>Amazon S3</li><li>Google Cloud Storage</li><li>Snowflake</li></ul></li> <li>Kafka - 如果您正在使用 <span>資料移動閘道</span>，則需要版本 2025.5.42 或更高版本。</li> <li>如果您正在使用 <span>資料移動閘道</span>，則以下目標需要版本 2025.11.1 或更高版本：<ul><li>Google BigQuery </li><li>適用於 PostgreSQL 的 Google Cloud Alloy DB (透過 PostgreSQL 連接器)</li><li>適用於 PostgreSQL 的 Google Cloud SQL (透過 PostgreSQL 連接器)</li><li>Microsoft Azure Database for PostgreSQL (透過 PostgreSQL 連接器)</li><li>PostgreSQL</li></ul></li> </ul> |

如需更多關於控制表格的資訊，請參閱 [控制表格](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/control_tables.htm)。

## 完整載入

### 基本

這些設定會在資料任務準備階段期間以及每當重新載入資料表時套用。

如果目標表格已存在：選取下列其中一項，以決定資料應如何載入至目標表格：

資訊備註

只有在來源端點支援這類操作時，捨棄或截斷目標表格的選項才會相關。

* 卸除並建立資料表： 目標資料表會被卸除，並在其位置建立新的資料表。

  資訊備註

  不會捨棄複寫任務控制表格。不過，若載入關聯的任務，也會從 [attrep_suspended_tables](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/suspended_tables.htm) 控制表格刪除任何已捨棄的暫停表格。

* 在載入之前截斷：會截斷資料，而不影響目標表格中繼資料。請注意，若選取此選項，啟用[在完整載入完成之後建立主要金鑰或唯一索引](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm#pk-create)選項不會有影響。

  資訊備註若 Microsoft Fabric 是目標平台，則不受支援。

* 略過：目標資料表的現有資料與中繼資料不會受到影響。新的資料將會新增至表格。

### 進階

#### 效能微調

資訊備註這些設定不適用於使用 SaaS 應用程式連接器的任務。

若資料複寫過低，調整下列參數可能會改善效能。

* 表格數量上限：輸入一次載入到目標中的表格數量上限。預設值為 5。

* 交易一致性逾時 (秒)：輸入在開始完整載入操作之前複寫任務應等待開放的交易關閉的秒數。預設值為 600 (10 分鐘)。複寫任務將會在達到逾時值之後開始完整載入，即使有開放的交易也是如此。

  資訊備註若要複寫完整載入開始時開放但僅在達到逾時值之後認可的交易，您需要載入目標表格。

* 完整載入期間的認可率： 可一起傳輸的事件數上限。預設值為 10000。

#### 完整載入完成之後

您可以設定任務以在完整載入完成之後自動停止。若您需要在任務的套用變更 (即CDC) 階段開始。

在完整載入期間，會快取在來源表格執行的任何 DML 操作。完整載入完成時，快取的變更會自動套用至目標表格 (只要停用以下描述的套用快取變更之前/之後選項即可)。

* [](https://help.qlik.com/en-US/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm)建立主索引鍵或唯一索引： 如果您想要延遲在目標上建立主索引鍵或唯一索引，直到完整載入完成為止，請選取此選項。

  資訊備註此設定不適用於使用 SaaS 應用程式連接器的任務。

* 停止任務：

  資訊備註

  複寫至資料倉儲目標時無法使用這些設定

  * 在套用快取的變更之前：選取以在完整載入完成後停止任務。

  * 套用快取的變更之後： 選取此選項可在工作中的所有資料表資料一致時立即停止工作。

  資訊備註

  設定要在完整載入完成之後停止的任務，請注意下列事項：

  * 任務不會在完整載入完成當下停止。這只會在擷取第一個變更批次之後停止 (因為這是觸發任務停止的事項)。這可能需要一些時間，視來源資料庫的更新頻率而定。任務停止後，變更將不會套用至目標，直到繼續任務為止。
  * 選擇套用快取變更之前可能會影響效能，因為快取的變更只會在最後一個表格完成完整載入之後套用至表格 (即使是已完成完整載入的表格仍是如此)。
  * 若選取此選項且在完整載入流程期間 (在完整載入和套用變更任務) 對來源表格之一執行 DDL，複寫任務將會載入表格。這明確表示，對來源表格執行的任何 DML 操作將會在任務停止之前複寫到目標。

#### 用於初始載入

資訊備註這些設定不適用於使用 SaaS 應用程式連接器的任務。

資訊備註若您使用 資料移動閘道 存取資料來源，這些設定需要版本 2022.11.74 或更高版本。

| 使用快取的資料 | 此選項可讓您使用透過所選的完整資料掃描產生中繼資料時讀取的快取資料。<br><br>這會對 API 使用和配額產生較少的負荷，因為已從來源讀取資料。可以透過變更資料擷取 (CDC) 選取自初始資料掃描以來的任何變更。 |
| --- | --- |
| 從來源載入資料 | 此選項從資料來源執行新的載入。如有以下情況，此選項很實用：<br><br><ul> <li> <p>最近沒有執行中繼資料掃描。</p> </li> <li> <p>來源資料集很小且頻繁變更，且您不想維持完整的變更歷史記錄。</p> </li> </ul> |

## 套用變更

只有在啟用套用變更複寫模式時，才能使用這些設定。

### 基本

#### 選取要套用至目標的 DDL 變更類型

資訊備註從 SaaS 應用程式來源複寫時，這些設定不可用。

下列選項決定在對應來源表格上執行的 DDL 操作是否也要在目標表格上執行。

* 卸除資料表： 選取即可在卸除來源資料表時卸除目標資料表。

  資訊備註若 Kafka 是目標平台，則不受支援。

* 截斷資料表： 選取此選項以在來源資料表被截斷時截斷目標資料表。

  資訊備註若 Microsoft Fabric 是目標平台，則不受支援。

* 變更資料表：選取此選項以在來源資料表變更時變更目標資料表。

  資訊備註若 Kafka 是目標平台，則不支援重新命名資料表。

#### 變更處理微調

* 將批次變更同時套用至多個表格：從多個來源表格套用變更時，選取此選項可能會改善效能。

  資訊備註

  只有在下列情況下，才支援此選項：

  * 套用變更模式設定為批次最佳化。如需詳細資訊，請參閱[複寫設定](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm#Replicat)。
  * 複寫目標不是 MySQL、PostgreSQL、Oracle 和 Google BigQuery。

  * 資料表數量上限： 可同時套用批次變更的資料表數量上限。預設為五，上限為 50，下限為二。

    若啟用將批次變更同時套用至多個表格選項，則下列限制適用：

    * 環境和表格錯誤的任務錯誤處理政策預設將會不變，但資料錯誤和套用衝突錯誤的預設將如下：

      * 資料錯誤：
        * 資料截斷錯誤：將記錄記錄到例外表格
        * 其他資料錯誤： 暫停資料表
      * 套用衝突錯誤：
        * 刪除： 忽略記錄

        * 插入： 更新現有的目標記錄

          資訊備註這與 Snowflake 目標無關 (因為 Snowflake 不支援主要金鑰)。

        * 更新： 忽略記錄
      * 呈報動作：
        * 不支援資料錯誤和套用衝突的呈報動作。
      * 不支援 [attrep_apply_exception](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/apply_exceptions.htm) 控制表格。
      * 對於資料錯誤：
        * 將記錄記錄到例外表格選項僅可用於資料截斷錯誤。
        * 沒有忽略選項。
      * 對於套用衝突：
        * 將記錄記錄到例外表格選項無法使用。

        * 忽略選項僅可用於找不到記錄以套用更新套用衝突。

    另請參閱：[處理時發生錯誤](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm#Error)。

* 將每個變更處理陳述式套用的變更數目限制為： 若要限制在單一變更處理陳述式中套用的變更數目，請選取此核取方塊，然後視需要變更預設值。預設值為 10,000。

  資訊備註只有下列目標才支援此選項：MySQL、PostgreSQL、Oracle 和 Google BigQuery。

### 進階

請參閱 [變更處理微調](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm#Change)。

## 儲存變更

只有在啟用儲存變更複寫模式時，才能使用這些設定。

### 基本

#### DDL 選項

資訊備註從 SaaS 應用程式來源複寫時，這些設定不可用。

選取下列選項之一，以決定如何在來源表格處理 DDL 操作：

* 套用至變更表格：對來源表格的 DDL 操作 (例如新增的欄) 只會套用至對應的變更表格。
* 忽略：將會忽略對來源表格的所有 DDL 操作。

### 進階

#### 更新時

資訊備註此設定與 SaaS 應用程式來源無關，因為會套用變更作為插入操作。

選取儲存之前和之後影像以儲存更新前的資料和更新後的資料。若未選取，只會儲存更新後的資料。

#### 變更表格建立

以下區段描述在變更表格中儲存變更時可用的選項。

* 字尾：指定要作為所有變更資料表字尾的字串。預設值為 \_\_ct。變更表格名稱是附加尾碼的目標表格名稱。例如，使用預設值時，變更表格的名稱將會是 HR\_\_ct。
* 標頭欄位前置詞：指定要作為所有變更資料表標頭欄位前置詞的字串。預設值是 header\_\_。例如，使用預設值時，標頭欄 stream\_position 將會稱為 header\_\_stream\_position。

如需更多關於變更表格的資訊，請參閱 [使用變更表格](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/use_change_tables.htm)。

若完整載入開始時存在變更表格：選取下列內容之一，以決定如何在完整載入複寫開始時載入變更表格：

* 捨棄並建立變更表格：會捨棄表格並在其位置建立新的表格。

* 在現有變更表格中刪除舊的變更並儲存新的變更：會截斷並新增資料，而不影響表格中繼資料。

  資訊備註若 Microsoft Fabric 是目標平台，則不受支援。

* 在現有變更表格中保留舊的變更並儲存新的變更：不會影響現有變更表格的資料和中繼資料。

#### 表格標頭欄

變更表格標頭欄提供關於變更處理操作的資訊，例如操作類型 (例如插入)、認可時間等。若您不需要此所有資訊，可以設定 移動 任務，以建立含所選標頭欄 (或完全不含) 的變更表格，藉此降低在目標資料庫中的所占空間。

資訊備註您無法在任務執行時移除其他欄或還原欄。若要變更您的初始選項，您需要先停止任務，然後修改選項，最後載入目標表格。

如需標頭欄的描述，請參閱 [變更表格](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/read_change_tables.htm)。

## 處理時發生錯誤

### 基本

#### 套用衝突

套用 INSERT 時發生重複金鑰： 選取當 INSERT 作業發生衝突時要採取的動作。

資訊備註從 SaaS 應用程式來源複寫時，僅支援更新現有的目標記錄動作。

* 忽略：任務會繼續並忽略錯誤。

* 更新現有的目標記錄：會更新主要金鑰與插入的來源記錄相同的目標記錄。

* 將記錄記錄到例外表格 (預設)：任務會繼續，錯誤會寫入到例外表格。

* 暫停表格：任務會繼續，但具有錯誤記錄之表格中的資料會移至錯誤狀態，並且不會複寫其資料。

* 停止任務：任務會停止，需要手動干預。

找不到套用 UPDATE 的記錄： 選取當 UPDATE 作業發生衝突時要採取的動作。

資訊備註從 SaaS 應用程式來源進行複寫時，僅支援 插入遺漏的目標記錄 動作。

* 忽略：任務會繼續並忽略錯誤。

* [](https://help.qlik.com/en-US/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm)插入遺失的目標記錄：遺失的目標記錄將會插入到目標表格中。若來源端點是 Oracle，選取此選項需要補充記錄，以便為所有來源表格欄啟用。

* 將記錄記錄到例外表格 (預設)：任務會繼續，錯誤會寫入到例外表格。

* 暫停表格：任務會繼續，但具有錯誤記錄之表格中的資料會移至錯誤狀態，並且不會複寫其資料。

* 停止任務：任務會停止，需要手動干預。

### 進階

資訊備註

僅在套用變更複寫模式 (而非完整載入) 中支援資料錯誤處理。

#### 資料錯誤

對於資料截斷錯誤：選取當截斷發生於一個或多個特定記錄時，您想要發生的事項。您可以從清單中選取下列內容之一：

* 忽略：任務會繼續並忽略錯誤。
* 將記錄記錄至例外表格 (預設)：任務會繼續，錯誤會寫入到例外表格。
* 暫停表格：任務會繼續，但具有錯誤記錄之表格中的資料會移至錯誤狀態，並且不會複寫其資料
* 停止任務：任務會停止，需要手動干預。

對於其他資料錯誤：選取當錯誤發生於一個或多個特定記錄時，您想要發生的事項。您可以從清單中選取下列內容之一：

* 忽略：任務會繼續並忽略錯誤。
* 將記錄記錄至例外表格 (預設)：任務會繼續，錯誤會寫入到例外表格。
* 暫停表格：任務會繼續，但具有錯誤記錄之表格中的資料會移至錯誤狀態，並且不會複寫其資料
* 停止任務：任務會停止，需要手動干預。

在達到其他資料錯誤 (每個表格) 時呈報錯誤處理：選取此核取方塊，以在非截斷資料錯誤數量 (每個表格) 達到指定量時呈報錯誤處理。有效值為 1-10,000。

呈報動作：選擇呈報錯誤處理時應發生什麼事。請注意，可用動作取決於從上述對於其他資料錯誤下拉式清單中選取的動作。

* 暫停表格 (預設)：任務會繼續，但具有錯誤記錄之表格中的資料會移至錯誤狀態，並且不會已移動其資料。

  資訊備註

  行為根據變更處理模式而異：

  * 在交易套用模式中，將不會已移動上次變更。

  * 在批次最佳化套用模式中，可能有完全不會已移動資料或僅部分已移動資料的情況。

* 停止任務：任務會停止，需要手動干預。

* 將記錄記錄至例外表格：任務會繼續，記錄會寫入到例外表格。

#### 表格錯誤

遇到表格錯誤時：從下拉式清單選取下列內容之一：

* 暫停表格 (預設)：任務會繼續，但具有錯誤記錄之表格中的資料會移至錯誤狀態，並且不會複寫其資料
* 停止任務：任務會停止，需要手動干預。

在表格錯誤達到時呈報錯誤處理 (每個表格)：選取此核取方塊，以在表格錯誤數量 (每個表格) 達到指定量時呈報錯誤處理。有效值為 1-10,000。

呈報動作：表格錯誤的呈報政策設定為停止任務且無法變更。

#### 套用衝突

資訊備註從 SaaS 應用程式來源複寫時，這些設定不可用。

[](https://help.qlik.com/en-US/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm)對套用刪除找不到記錄：選取與刪除操作有衡突時所採取的動作。

* 忽略：任務會繼續並忽略錯誤。
* 將記錄記錄到例外表格：任務會繼續，記錄會寫入到例外表格。
* 暫停表格：任務會繼續，但具有錯誤記錄之表格中的資料會移至錯誤狀態，並且不會複寫其資料。
* 停止任務：任務會停止，需要手動干預。

在套用衝突達到時呈報錯誤處理 (每個表格)：選取此核取方塊，以在套用衝突數量 (每個表格) 達到指定量時呈報錯誤處理。有效值為 1-10,000。

呈報動作：選擇呈報錯誤處理時應發生什麼事：

* 將記錄記錄到例外表格 (預設)：任務會繼續，錯誤會寫入到例外表格。

* 暫停表格：任務會繼續，但具有錯誤記錄之表格中的資料會移至錯誤狀態，並且不會複寫其資料。

  資訊備註

  行為根據變更處理模式而異：

  * 在交易套用模式中，將不會複寫上次變更

  * 在批次最佳化套用模式中，情況可能是沒有資料複寫或資料複寫是局部處理。

* 停止任務：任務會停止，需要手動干預。

#### 環境錯誤

* 重試計數上限：選取此選項，然後指定在可修復的環境錯誤發生時重試任務的嘗試次數上限。在重試任務達到指定次數之後，任務會停止，需要手動干預。

  若絕對不要重試任務，清除核取方塊或指定「0」。

  若要重試任務無限次數，指定「-1」

  * 重試嘗試之間的間隔 (秒)：使用計數器以選取或輸入系統在每次嘗試重試任務之間等待的秒數。

    有效值為 0-2,000。

* 對長時間中斷增加重試間隔：選取此核取方塊以對長時間中斷增加重試間隔。若啟用此選項， 會加倍每次重試嘗試之間的間隔，直到達到重試間隔上限為止 (並根據指定的間隔上限繼續重試)。

  * 重試間隔上限 (秒)：在啟用對長時間中斷增加重試間隔選項時，使用計數器以選取或輸入每次嘗試重試任務之間等待的秒數。有效值為 0-2,000。

## 變更處理微調

### 交易卸載微調

* 對磁碟的卸載交易進行中，條件是：

  複寫任務通常會將交易資料保留在記憶體中，直到對來源和/或目標完全認可為止。不過，大於配置記憶體或未在指定期限內認可的交易將會卸載到磁碟。

  * 交易記憶體大小超過 (MB)：在卸載到磁碟之前，所有交易可以在記憶體中占用的大小上限。預設值為 1024。
  * 交易期間超過 (秒)：在卸載到磁碟之前，每筆交易可以在記憶體中停留的時間上限。持續時間是從複寫任務開始擷取交易的時間計算。預設值為 60。

### 批次微調

此索引標籤中的設定由套用變更模式決定。

資訊備註複寫至資料倉庫目標或使用 Qlik Talend Cloud 啟動器 訂閱時，您無法選取要使用哪個套用變更模式。變更永遠會在批次最佳化模式下套用，以提供最大效率。對此的例外情況是複寫到 Snowflake 目標且載入方法 設定為 Snowpipe 串流時。在這種情況下，雖然您仍然無法選取要使用哪一種套用變更模式，但變更將一律在交易模式下套用。

#### 只有在「套用模式」設定為「批次最佳化」時才能使用的設定

* 以間隔套用批次變更：

  * 大於：每次應用程式批次變更之間等待的時間長度下限。預設值為 1。

    增加大於值會減少變更套用至目標的頻率，同時增加批次大小。若將變更套用至為處理大型批次而最佳化的目標資料庫，這可以改善效能。

  * 小於：每次應用程式批次變更之間等待的時間長度上限 (宣告逾時之前)。換言之，即可接受的延遲上限。預設值為 30。此值決定套用變更之前、達到大於值之後要等待的時間長度上限。

* 在處理記憶體超過時強制套用批次 (MB)：要在批次最佳化套用模式下用於預先處理的記憶體量上限。預設值為 500。

  如需最大批次大小，請將此值設定為您可以配置到複寫任務的最高記憶體量。若將變更套用至為處理大型批次而最佳化的目標資料庫，這可以改善效能。

#### 只有在「套用模式」設定為「交易」時才能使用的設定

只有在「交易」套用模式下，才能使用下列設定。請注意，複寫到 Snowflake 且載入方法是 Snowpipe 串流時，「交易」是唯一可用的套用模式 (因此無法選取)。

* 每個交易的變更數量下限：要在每個交易中納入的變更數量下限。預設值為 1000。

  資訊備註

  若變更數量等於或大於每個交易的變更數量下限值，或者若達到套用之前的批次交易時間上限 (秒) 值 (以先發生者為主)， 會將變更套用至目標。因為套用至目標的變更頻率由這兩個參數控制，對來源記錄的變更可能不會立即反映在目標記錄中。

* 套用之前的批次交易時間上限 (秒)：宣告逾時之前批次收集交易的時間上限。預設值為 1。

### 間隔

資訊備註這些設定僅適用於 SAP ODP 連接器。

* 讀取變更間隔 (分鐘)

  設定從來源讀取變更之間的間隔，單位為分鐘。有效範圍為 1 至 1440。

  資訊備註

  此選項僅適用於使用以下方式的任務：

  * 資料移動閘道
  * 套用變更或儲存變更更新方法

查看變更

* 根據差異擷取間隔：選取此選項時，資料任務會根據差異擷取間隔檢查變更。

  資訊備註每個「回合」結束後，間隔就會開始。一個回合可定義為資料任務從來源表格讀取變更並將其傳送至目標所需的時間 (作為單一交易)。回合的長度會根據表格和變更的數量而異。因此，如果您指定 10 分鐘的間隔，而一個回合需要 4 分鐘，則檢查變更之間的實際時間將為 14 分鐘。

  * 差異擷取間隔： 從您的系統中擷取差異的頻率。預設為每 60 秒一次。

* 依排程：選取此選項時，資料任務將擷取差異一次，然後停止。然後將依排程繼續執行。

  資訊備註此選項僅在 CDC 週期之間的間隔為 24 小時或更長時間時才相關。

  如需排程資訊：

  * 複寫專案中的「複寫資料任務」，請參閱 [排程任務](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm#Scheduli2)

### 雜項微調

#### 陳述式快取大小 (陳述式數量)

要儲存在伺服器以供之後執行的所準備之陳述式數量上限 (將變更套用至目標時)。預設為 50。上限為 200。

#### 在更新主要金鑰欄時刪除和插入

此選項僅在啟用 儲存變更 複寫模式時可用，且需要在來源資料庫中啟用完整補充記錄。

#### 在 DELETE 傳送標記

資訊備註此選項僅在使用 Kafka 目標連接器時可用。

當選取此選項時，只有訊息金鑰會被填入；訊息本身將為 null，表示該項目已被刪除。這可以協助消費者偵測到已執行 DELETE 作業。

#### 在目標資料庫中儲存任務復原資料

資訊備註複寫至[資料倉庫目標](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/data-warehouses-connections.htm)時，此選項無法使用。

選取此選項以將任務特定復原資訊儲存在目標資料庫中。選取此選項後，複寫任務會在目標資料庫中建立名稱為 `attrep_txn_state` 的表格。若 資料移動閘道資料資料夾中的檔案損毀，或者若包含資料資料夾的儲存裝置故障，則此表格包含可用來復原任務的交易資料。

#### 使用 SQL 合併套用變更

資訊備註只有在複寫至特定[資料倉庫目標](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/data-warehouses-connections.htm)時，此選項才能使用 (請參閱以下詳細資訊)。

若未選取此選項，複寫任務將會為淨變更表格中每種不同的變更類型，執行大量獨立的 INSERT、UPDATE 和 DELETE 陳述式。

提示備註以批次最佳化套用模式運作時，淨變更表格會建立於目標，並包含已在來源變更的記錄。這會在每次來源變更套用至目標時截斷。

雖然此方法效率很高，但使用支援使用 SQL MERGE 套用變更的端點時，啟用此選項更有效率。

這是因為下列原因：

* 這將每個表格執行的 SQL 陳述式數量從三個減少為一個。大型、不可變、基於檔案的雲端資料庫 (例如 Google Cloud BigQuery) 中，大部分的 UPDATE 操作涉及重新寫入受影響的檔案。透過這類操作，將每個表格的 SQL 陳述式從三個減少為一個非常重要。
* 目標資料庫只需要掃描淨變更表格一次，大幅降低 I/O。

最佳化插入

若同時選取使用 SQL MERGE 套用變更和最佳化插入選項，且變更僅包括 INSERT，則複寫任務將會執行 INSERT，而非使用 SQL MERGE。請注意，由於這通常會改善效能並藉此降低成本，這也可能會在目標資料庫中產生複製記錄。

資訊備註

* 使用 SQL MERGE 套用變更和最佳化插入選項僅可用於透過下列目標端點設定的任務：

  * Google Cloud BigQuery
  * Databricks
  * Snowflake

* 下列來源端點不支援使用 SQL MERGE 套用變更和最佳化插入選項：

  * Salesforce
  * Oracle

* 若啟用使用 SQL MERGE 套用變更選項：

  * 非重大資料錯誤或無法復原的資料錯誤將會作為表格錯誤來處理。
  * 透過下列設定，將無法編輯[套用衝突錯誤處理政策](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm#Apply2)。
    * 找不到套用刪除的記錄：忽略記錄

    * 套用 INSERT 時發生重複索引鍵：UPDATE 現有的目標記錄

      資訊備註若也選取了最佳化插入選項，在套用 INSERT 時複寫金鑰選項將設定為允許在目標中複寫。

    * 找不到套用 UPDATE 的記錄： INSERT 缺少的目標記錄

    * 升級動作： 將記錄寫入例外狀況資料表
  * 下列對於其他資料錯誤[資料錯誤處理政策](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm#Data)選項將無法使用：
    * 忽略記錄
    * 記錄檔記錄至例外表格
  * 只會在最終目標表格執行實際 SQL MERGE 操作。將會在中繼變更表格執行 INSERT 操作 (若啟用套用變更或儲存變更複寫模式)。

### 交易套用

資訊備註

複寫至資料倉庫目標或不使用 資料移動閘道 時，這些選項不相關，因為套用模式永遠是批次最佳化，但有一個例外情況。

對此的例外情況是複寫到 Snowflake 且載入方法 設定為 Snowpipe 串流時。

只有在交易套用模式下，才能使用下列設定。複寫到資料庫時，套用模式可以設定為批次最佳化或交易。不過，若複寫到 Snowflake 目標且載入方法設定為 Snowpipe 串流，則套用模式一律是交易，因此無法設定。

* 每個交易的變更數量下限：要在每個交易中納入的變更數量下限。預設值為 1000。

  資訊備註若變更數量等於或大於每個交易的最低變更數量值，或者若達到批次逾時值 (見下文) (以先發生者為主)，複寫任務會將變更套用至目標。因為套用至目標的變更頻率由這兩個參數控制，對來源記錄的變更可能不會立即反映在目標記錄中。

* 套用之前的批次交易時間上限 (秒)：宣告逾時之前批次收集交易的時間上限。預設值為 1。

## 自動結構描述演進

資訊備註使用 SaaS 應用程式連接器時，僅支援 變更資料行資料類型。

選取如何處理結構描述中以下類型的 DDL 變更。變更結構描述演進設定後，您必須重新準備任務。下表描述了哪些動作可用於支援的 DDL 變更。

| DDL 變更 | 套用至目標 | 忽略 | 暫停表格 | 停止任務 |
| --- | --- | --- | --- | --- |
| 新增欄 | 是 | 是 | 是 | 是 |
| 變更欄資料類型 | 是 | 是 | 是 | 是 |
| 重新命名欄 | 是 | 否 | 是 | 是 |
| 重新命名表格<br><br>資訊備註若 Kafka 是目標平台，則不受支援。 | 否 | 否 | 是 | 是 |
| 捨棄欄 | 是 | 是 | 是 | 是 |
| 捨棄表格<br><br>資訊備註若 Kafka 是目標平台，則不受支援。 | 是 | 是 | 是 | 是 |
| 建立表格<br><br>如果您使用選取規則新增與模式相符的資料集，則會偵測到並新增符合該模式的新表格。 | 是 | 是 | 否 | 否 |

## 字元替代

您可以替代或刪除目標資料庫中的來源字元，以及/或您可以替代或刪除所選字元集合不支援的來源字元。

資訊備註

* 必須指定所有字元作為 Unicode 字碼指標。

* 也會在控制表格執行字元替代。

* 將會透過表格儲存格右上方的紅色三角形指示無效的值。將滑鼠游標暫留在三角形上方，將會顯示錯誤訊息。

* 將會在字元替代完成之後，執行為任務定義的任何表格層級或全域轉換。

* 會在替代或刪除所選字元集合不支援的來源字元表格中定義的替代動作之前，執行替代或刪除來源字元表格中定義的替代動作。

* 字元替代不支援 LOB 資料類型。

### 替代或刪除來源字元

使用替代或刪除來源字元表格，以定義更換特定來源字元。例如，若 Unicode 字元表示法在來源和目標平台不同，這可能會很實用。例如，在 Linux，`Shift_JIS` 字元集合中的減號字元以 `U+2212` 表示，但在 Windows 則以 `U+FF0D` 表示。

替代動作

| 至 | 進行此 |
| --- | --- |
| 定義替代動作。 | <ol> <li> <p>按一下表格上方的<span>新增字元</span>按鈕。</p> </li> <li> <p>分別在<span>來源字元</span>和<span>替代字元</span>欄位中指定來源字元和目標字元。</p> <p>例如，若要以字母「e」取代字母「a」，請分別指定 <code>0061</code> 和 <code>0065 </code>。</p> <div><span>資訊備註</span> <p>若要刪除指定的來源字元，在<span>替代字元</span>欄中輸入 <code>0</code>。</p> </div> </li> <li>重複步驟 1-2 以取代或刪除其他字元。</li> </ol> |
| 編輯指定的來源或目標字元 | 按一下列末尾的 the 編輯 icon，並選取。 |
| 從表格中刪除項目 | 按一下列末尾的 the 刪除 icon，並選取。 |

### 替代或刪除所選字元集合不支援的來源字元

使用字元集合不支援的來源字元表格，為所選字元集合不支援的所有字元定義單一替換字元。

不支援的字元替代動作

| 至 | 進行此 |
| --- | --- |
| 定義或編輯替代動作。 | <ol> <li> <p>從表格中的<span>字元集合</span>下拉式清單選取字元集合。</p> <p>將會透過以下步驟 2，在目標以指定的字元取代所選字元集合不支援的任何字元。</p> </li> <li> <p>在<span>替代字元</span>欄中，按一下欄中的任何地方並指定替換字元。例如，若要以字母「a」取代所有不支援的字元，請輸入 <code>0061</code>。</p> <div><span>資訊備註</span> <p>若要刪除所有不支援的字元，請輸入 <code>0</code>。</p> </div> </li> </ol> |
| 停用替代動作。 | 從字元集合下拉式清單中選取空白項目。 |

## 更多選項

不會在 UI 中暴露這些選項，因為這僅與特定版本或環境相關。因此，請勿設定這些選項，除非 Qlik 支援或產品文件明確指示這麼做。

若要設定選項，只要在新增特徵名稱欄位中複製選項並按一下新增即可。然後根據您收到的說明設定值或啟用選項。

## 平行載入資料集區段

資訊備註此設定不適用於 SaaS 應用程式來源，僅適用於來源資料庫和目標資料庫的特定子集。

在完整載入期間，您可以將資料集分成多個平行載入的區段，以加速大型資料集的載入。表格可以按照資料範圍、所有分割、所有子分割或特定分割進行分割。

如需詳細資訊，請參閱[平行複寫資料集區段](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/Table-settings-replication.htm)。

## 排程任務

在某些情況下，您可能需要為您的工作排程，以將變更從資料來源傳播至目標平台。

如需詳細資訊，請參閱[Scheduling tasks](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Deploying/Scheduling-tasks.htm)。