# 偵測機器學習模型中的偏差
您可以識別在 ML 實驗中訓練的機器學習模型中的偏差。此外,您可以選擇從大型語言模型 (LLM) 取得可能容易產生偏差的功能建議。 透過捨棄偏斜的功能、更正不正確的資料收集,或變更訓練資料集的結構來解決偵測到的偏差。
警告備註
Qlik 不保證任何偏差偵測結果的準確度、完整性或可靠性,也不確保符合任何當地、州、聯邦或國際法律、法規或產業標準。使用者應承擔根據工具輸出所採取之任何行動的所有風險和責任,此輸出不應取代專業法律建議或獨立人工稽核。
警告備註
偏差偵測具有選用元件,其使用生成式人工智慧 (GenAI) 來建議可能容易產生偏差的功能。使用者有責任檢閱並驗證任何 GenAI 建議,並評估其使用是否適合任何特定使用情況,以及是否遵守適用法律。
## 瞭解偏差
在機器學習中,偏差是一種不希望發生的現象,其中模型偏袒或可能偏袒某些群體而非其他群體。偏差會對公平性產生負面影響,並對預測以及它們所影響的決策產生道德影響。偏差可能產生於訓練資料中、經訓練模型預測的結果中,或兩者皆有。
偏差的範例—及其對決策的影響—包括:
* 在不成比例地代表某些收入水準或健康狀況的資料上訓練模型,導致保險理賠的不公平決策。
* 在關於候選人種族和性別的偏斜資料上訓練模型,影響聘用決策。
* 訓練將郵遞區號與信用度關聯起來的模型。
### 資料偏見
資料偏差發生在用於訓練模型的資料存在偏差,偏袒某些群體而非其他群體時。資料偏差是由於訓練資料中群體之間的不均等代表性所引起的。
例如,用於預測招聘結果的資料集可能包含將某個性別呈現為比其他性別更成功的資料。
資料偏差可以透過多種方式引入訓練資料中,包括:
* 不當的資料收集,其中某些群體代表性不足或代表性過高。
* 準確反映歷史模式的資料,但揭露了這些趨勢和做法中潛在的偏見。
下方視覺化中的資料指出資料偏見。
資料偏見的一個範例,以長條圖視覺化。在來源資料中,某些婚姻狀況相對於收入水準,其代表性比其他狀況高。
資料偏見的一個範例,以長條圖視覺化。在來源資料中,某些婚姻狀況相對於收入水準,其代表性比其他狀況高。
資料偏見的一個範例,以長條圖視覺化。在來源資料中,某些婚姻狀況相對於收入水準,其代表性比其他狀況高。 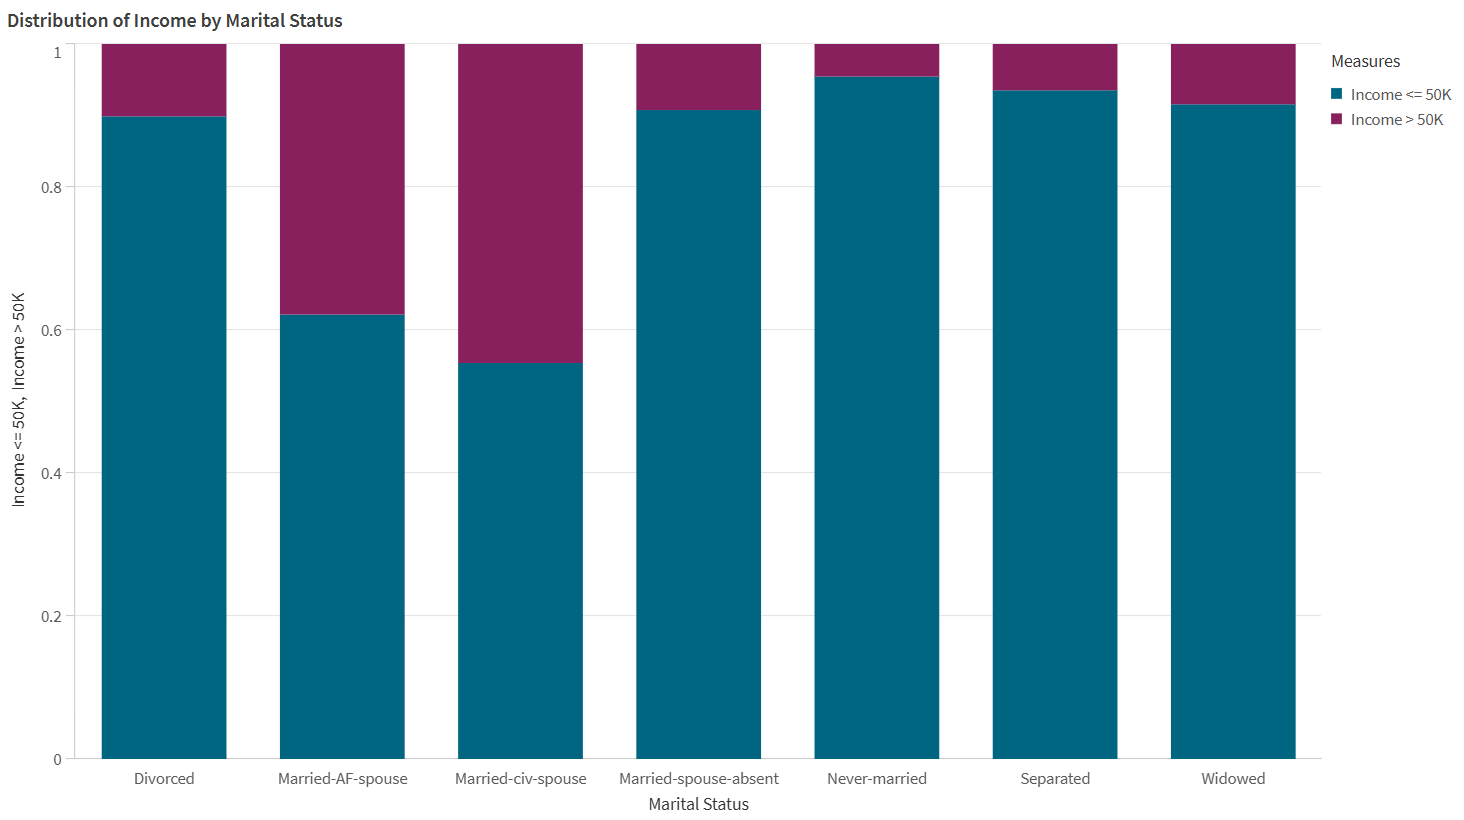
### 模型偏見
模型偏差,或稱演算法偏差,發生在機器學習模型所做的預測偏袒某些群體而非其他群體時。存在模型偏差時,模型會在某些群體和結果之間建立關聯,對其他群體產生負面影響。模型偏差可能由收集不當或偏斜的資料,以及所使用的訓練演算法的特定行為引起。
例如,模型可能會因為其所做的不公平關聯,而預測某些年齡群體的不成比例的負面雇用率。
來自機器學習實驗中分析分頁的視覺化,突顯模型偏差。視覺化顯示,模型對某些婚姻狀況的收入預測高於其他狀況。
來自機器學習實驗中分析分頁的視覺化,突顯模型偏差。視覺化顯示,模型對某些婚姻狀況的收入預測高於其他狀況。
來自機器學習實驗中分析分析分頁的視覺化,突顯模型偏差。視覺化顯示,模型對某些婚姻狀況的收入預測高於其他狀況。 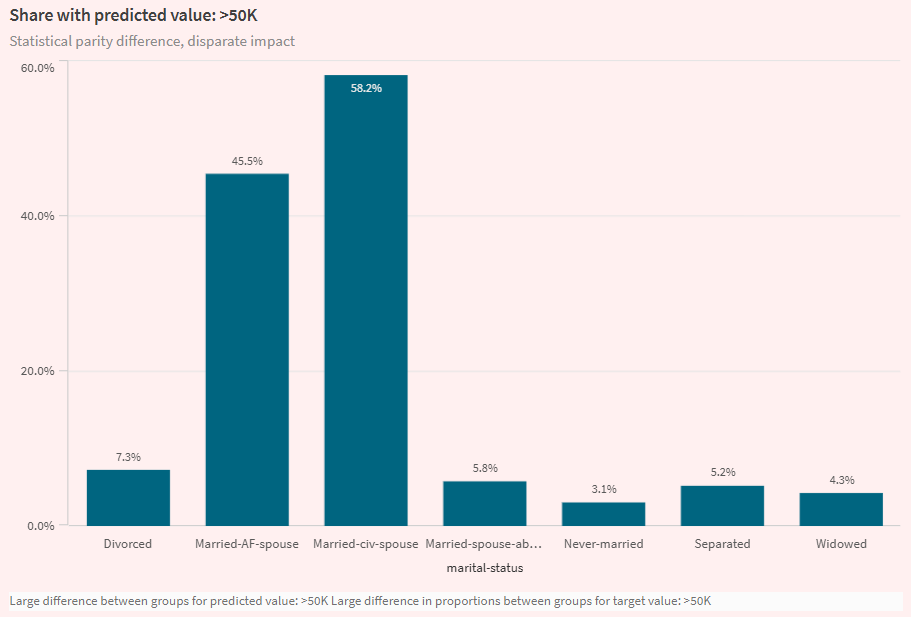
## 資料偏差指標
在Qlik Predict中,資料偏差是透過分析以下項目來衡量:
* 代表率:比較功能,特性中每個群組所屬資料的分佈,與功能,特性中所有資料的比較。計算出的度量是代表率同位比。
* 條件式分佈同位率:比較功能,特性中每個群組的資料平衡,相對於目標欄位的值。計算出的度量是條件式分佈同位率。
若要進一步瞭解這些度量的可接受值,請參閱[偏差指標的可接受值](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/bias-detection.htm#Metrics)。
## 模型偏差指標
在 Qlik Predict 中,模型偏差指標最好在實驗的模型類型背景下理解。廣義而言,有以下偏差指標類別:
* 分類模型指標
* 迴歸和時間序列模型指標
若要進一步瞭解這些指標的可接受值,請參閱 [偏差指標的可接受值](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/bias-detection.htm#Metrics)。
### 分類模型
在二元和多類別分類模型中,偏差是透過分析預測的目標值 (結果) 來衡量的。特別是,會比較群組中正面和負面結果率的差異 (此處的「正面」和「負面」是指有利與不利的結果,例如 已聘用 目標欄的 是 或 否 值)。這些模型具有下列偏差指標:
* 差別影響
* 統計同位差異
* 平等機會差異
#### 差別影響
差異影響比 (DI) 會評估敏感功能中的群組在模型的預測結果中是否受到偏袒或損害。它是透過計算每個群組被選為預測值的頻率,並將其與該功能中最受青睞群組的選取率進行比較來衡量。
#### 統計同位差異
類似於差異影響,統計均等差異 (SPD) 會評估模型預測,以判斷其是否偏袒或損害任何個別群組。此指標是透過比較最大群組和最小群組之間的正面結果率來計算。
#### 平等機會差異
機會均等差異 (EOD) 與其他兩個分類模型偏差指標類似。EOD 會比較某功能中各群組的最高和最低真實陽性率。
### 迴歸與時間序列模型
在迴歸與時間序列模型中,偏差是透過比較模型預測錯誤的頻率來衡量,並使用同位率來判斷預測結果的公平性。
追蹤的偏差指標是使用常用於評估模型準確度的錯誤指標來計算:
* MAE 同位率
[MAE](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/scoring-regression.htm#MAE)
* MSE 同位率
[MSE](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/scoring-regression.htm#MSE)
* RMSE 同位率
[RMSE](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/scoring-regression.htm#RMSE)
* R2 差距
[R2](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/scoring-regression.htm#R2)
* MASE 同位率
[MASE](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/scoring-time-series.htm#MASE)
* MAPE 同位率
[MAPE](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/scoring-time-series.htm#MAPE)
* SMAPE 同位率
[SMAPE](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/scoring-time-series.htm#SMAPE)
## 偏差指標的可接受值
偏差指標—可接受的範圍和值
| 偏差指標 | 偏差類別 | 適用模型類型 | 可接受的值 |
| --- | --- | --- | --- |
| 代表率同位率 | 資料偏見 | 全部 | 理想值:介於 0.8 和 1 之間。
較低的比例表示代表性不均。 |
| 條件式分佈同位率 | 資料偏見 | 全部 | 理想值:介於 0.8 和 1 之間。
較低的比例表示不成比例的代表性。 |
| 統計同位差異 (SPD) | 模型偏見 | 二進位分類、多類別分類 | 理想值:0。
高於 0.2 的值是強烈的不公平訊號。 |
| 差別影響 (DI) | 模型偏見 | 二進位分類、多類別分類 | 理想值:1。
低於 0.8 的值表示不公平。 |
| 平等機會差異 (EOD) | 模型偏見 | 二進位分類、多類別分類 | 理想值:0。
值高於 0.1 表示不公平。 |
| MAE 同位率 | 模型偏見 | 迴歸 | 理想值:介於 0.8 和 1 之間。
值高於 1.25 表示不公平。 |
| MSE 同位率 | 模型偏見 | 迴歸 | 理想值:介於 0.8 和 1 之間。
高於 1.25 的值表示不公平。 |
| RMSE 同位率 | 模型偏見 | 迴歸 | 理想值:介於 0.8 和 1 之間。
高於 1.25 的值表示不公平。 |
| R2 差距 | 模型偏見 | 迴歸 | 理想值:0。
高於 0.2 的值表示不公平。 |
| MASE 同位率 | 模型偏見 | 時間序列 | 高於 1.25 的值表示不公平。 |
| MAPE 同位率 | 模型偏見 | 時間序列 | 高於 1.25 的值表示不公平。 |
| SMAPE 同位率 | 模型偏見 | 時間序列 | 高於 1.25 的值表示不公平。 |
## 設定偏差偵測
偏差偵測是根據實驗版本中的每個訓練功能來設定的。
請執行下列動作:
1. 在 ML 實驗中,於訓練組態面板中展開 偏差。
2. 在選取用於偏差偵測的功能之前,您可以選擇按一下 取得建議,以使用生成式 AI 建議可能包含偏差資料的功能。請參閱 [使用生成式 AI 建議用於偏差偵測的功能](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/bias-detection.htm#UsingAI)。
3. 選取或取消選取您要執行偏差偵測的任何功能。
或者,在 the 結構定義檢視 icon 中,針對所需的功能開啟偏差偵測。
### 使用生成式 AI 建議用於偏差偵測的功能
您可以使用與大型語言模型 (LLM) 的內建整合,在執行實驗之前建議潛在的敏感功能。
運作方式
* 當您按一下 取得建議 時,LLM 會掃描功能名稱和資料樣本,以檢查您的哪些功能建議選取用於偏差偵測。
* 建議會產生以回應推斷請求,這些請求可能會在您的 Qlik Cloud 租用戶區域之外處理。
資訊備註無論是靜止還是傳輸中,您的資料一律會加密。
* 取得建議後,您可以檢閱每個建議的原因。例如,您可以查看某個功能是否因潛在的地理偏差而受到建議。
* LLM 的建議為英文。
按一下取得建議,以使用 AI 取得建議的功能,並在這些功能上執行偏差偵測。
按一下取得建議,以使用 AI 取得建議的功能,並在這些功能上執行偏差偵測。
按一下取得建議取得建議,以使用 AI 取得建議的功能,並在這些功能上執行偏差偵測。 
管理要求
* AI 功能 (即跨區域推斷) 必須由租用戶管理員啟用,此功能才能使用。這在 管理 活動中心進行。
如需詳細資訊,請參閱[啟用跨區域推斷](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/Admin/cross-region-data-processing.htm)。
* 除了設定實驗的權限之外,使用者必須擁有「管理 ML 實驗」權限,並將其設定為「允許」(在允許使用 GenAI 的情況下)。如需詳細資訊,請參閱[在 ML 實驗中使用 AI 工具](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/who-can-work-with-automl.htm#CreateUseExpAI)。
## 偏差結果的快速分析
訓練完成後,您可以在模型索引標籤中快速概述偏差偵測結果。
警告備註
Qlik 不保證任何偏差偵測結果的準確度、完整性或可靠性,也不確保符合任何當地、州、聯邦或國際法律、法規或產業標準。使用者應承擔根據工具輸出所採取之任何行動的所有風險和責任,此輸出不應取代專業法律建議或獨立人工稽核。
向下捲動快速分析項目以尋找偏差偵測。使用the 下拉箭頭向下 icon圖示展開區段。您可以分析可能具有資料和模型偏差的功能。
使用偏差偵測區段在模型索引標籤中分析資料偏差。
使用偏差偵測區段在模型索引標籤中分析資料偏差。
使用偏差偵測偏差偵測區段在模型模型索引標籤中分析資料偏差。 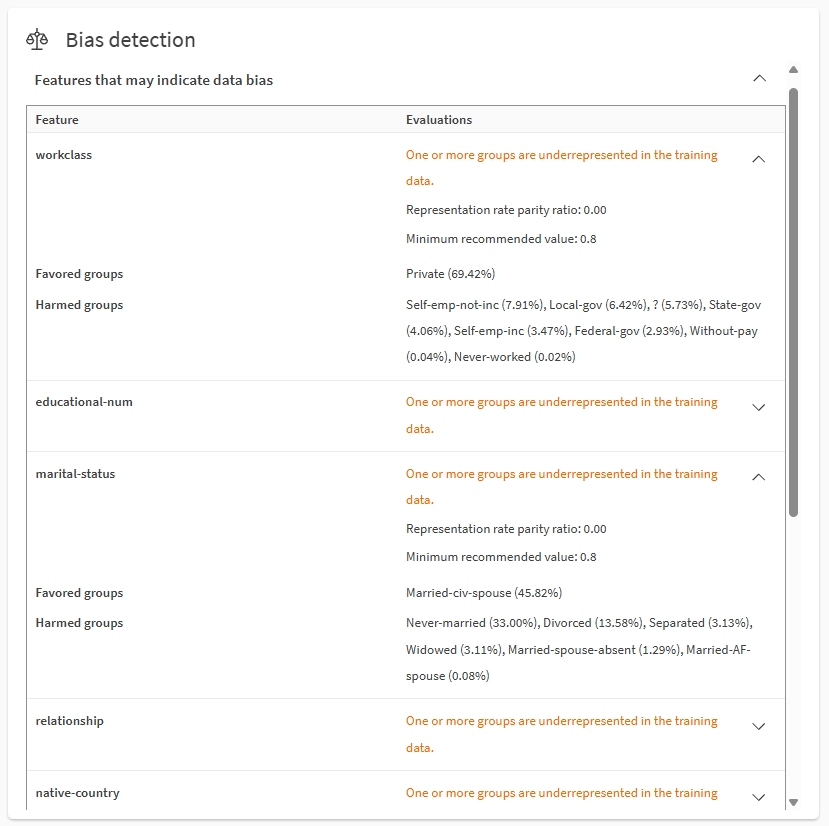
### 備註
* 受偏好群組是根據偏差度量,在資料或目標的預測結果中過度呈現的目標值或範圍。受損群組是根據偏差度量,在資料或目標的預測結果中呈現不足的目標值或範圍。
如需有關如何使用偏差度量的資訊,請參閱 [偏差指標的可接受值](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/bias-detection.htm#Metrics)。
括弧中的數字說明用於計算度量的準則。例如,如果指標是均等機會差異 (EOD),女性 (10%) 和男性 (80%) 表示男性的真實陽性率為 80%,女性為 10%。
* 目標結果 是指模型預測的目標欄位值。
* 由於空間有限,模型 索引標籤中並未顯示所有偏差指標和值。例如:
* 根據指標和模型類型,某些指標和群組可能只包含最小值和最大值。
* 如果多個指標超出某個功能的偏差閾值,則會顯示表示不公平程度最高的指標。
* 對於多類別分類模型中有偏差的功能,特性,只會顯示顯示最高程度不公平的指標。
* 更詳細的資訊可在分析分頁以及模型訓練報告中取得。請參閱 [偏差結果的詳細分析](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/bias-detection.htm#Detailed)。
* 如需此區段中術語的詳細資訊,請參閱[此頁面上的術語](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/bias-detection.htm#Terminology)。
## 偏差結果的詳細分析
您可以在分析分頁中深入探討偏差結果。
警告備註
Qlik 不保證任何偏差偵測結果的準確度、完整性或可靠性,也不確保符合任何當地、州、聯邦或國際法律、法規或產業標準。使用者應承擔根據工具輸出所採取之任何行動的所有風險和責任,此輸出不應取代專業法律建議或獨立人工稽核。
請執行下列動作:
1. 在 ML 實驗中,選取模型並前往分析索引標籤。
2. 開啟偏差工作表。
3. 視所需的分析而定,在資料偏差和模型偏差之間選取。
4. 在具有潛在偏差的功能表格中,選取單一功能。
指示可能偏差的圖表和度量會以紅色背景顯示。您可以透過按一下並在視覺化中繪製來選取特性。
表格中的指標對於與標準特性相對應的偏差指標是靜態的。對於未來的特性,偏差指標會根據[時間序列群組](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/bias-detection.htm#Terminology)的選取而動態變化。
分析索引標籤顯示所選特性的模型偏差分析。圖表和指標的紅色背景表示可能存在偏差。
分析索引標籤顯示所選特性的模型偏差分析。圖表和指標的紅色背景表示可能存在偏差。
分析分析索引標籤顯示所選特性的模型偏差分析。圖表和指標的紅色背景表示可能存在偏差。 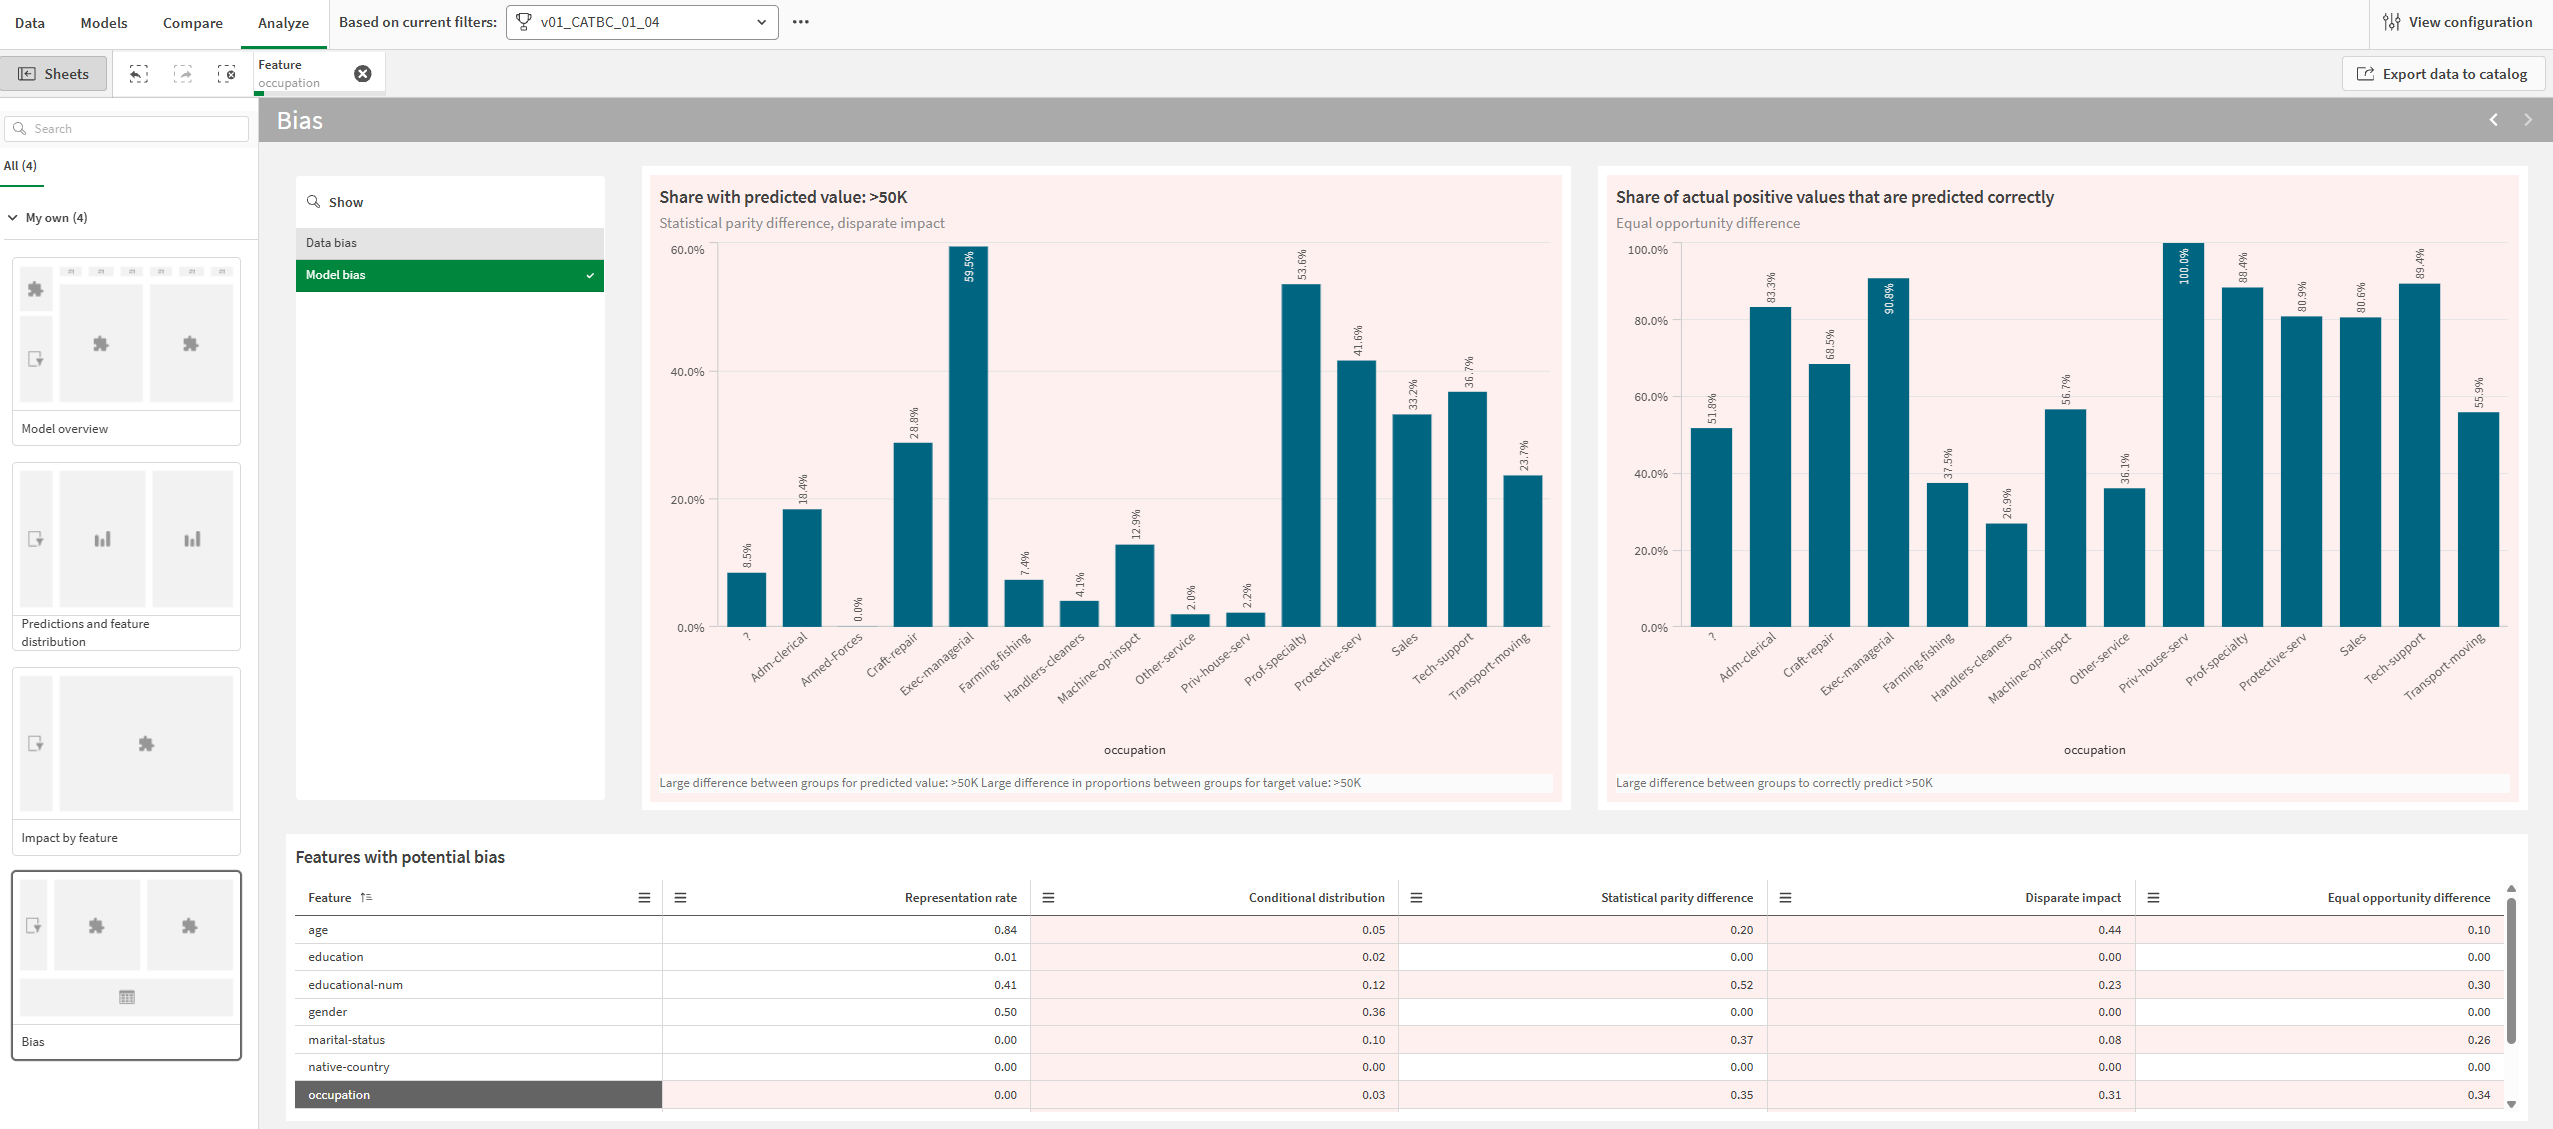
如需更多關於導覽詳細模型分析的資訊,請參閱 [執行詳細模型分析](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/analyze-models-detailed.htm)。
### 訓練報告中的偏差結果
偏差指標也會呈現在 ML 訓練報告中。它們會包含在報告中專屬的 偏差 區段。
如需訓練報告的詳細資訊,請參閱 [下載 ML 訓練報告](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/training-report.htm)。
## 處理偏差
分析模型的偏差偵測結果後,您可能需要執行下列任何一項操作:
* 在捨棄有偏差的功能後,執行新的實驗版本。
[設定新版本](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/refining-models.htm#Configur)
* 避免部署顯示偏差的模型,改為部署符合偏差指標建議準則的模型。
[部署模型](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/deploying-models.htm)
* 更新您的資料集,以修正任何不當的資料收集或解決不平等的代表率。
[準備用於訓練的資料集](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/dataset-preparation.htm)
* 使用結構化框架重新定義您的機器學習問題。例如,如果您的原始機器學習問題本身就存在偏見,模型在建立公平預測時可能總是不可靠。
[定義機器學習問題](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/machine-learning-framework.htm)
[使用多變量時間序列預測](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/machine-learning-framework-time-series.htm)
## 此頁面上的術語
在此頁面中,以及在 Qlik Predict 中,「群組」是一個根據上下文具有不同含義的術語:
* 「群組」是指正在分析偏見的功能,特性中的值或範圍。例如,「婚姻狀況」功能,特性在訓練資料中可能有四個可能的群組:「已婚」、「離婚」、「分居」或「喪偶」。
* 在時間序列實驗中,「群組」是指允許追蹤相容功能,特性特定值的目標結果的功能。在此頁面中,這些群組稱為「時間序列群組」。如需這些群組的詳細資訊,請參閱[群組](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/machine-learning-framework-time-series.htm#Groups)。
## 限制
* 如果啟用偏差偵測,則訓練資料集大小會有一些限制。請參閱 [訓練資料集和分析限制](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/ml-limitations-capacities.htm#DatasetSizeCapacities)。
* 您無法啟用下列項目的偏差偵測:
* 目標功能。
* 自由文字功能 (即使功能類型變更為類別型)。
* 用作時間序列實驗中日期索引的日期功能。
* 自動設計的日期功能。您可以在這些功能上執行偏差偵測,但您不會獨立啟用它們。相反地,啟用父日期功能用於偏差偵測,並確保自動工程化日期功能已包含在訓練中。
## 瞭解更多資訊
* [設定實驗](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/configuring-experiments.htm)
* [執行快速模型分析](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/analyze-models-quick.htm)
* [執行詳細模型分析](https://help.qlik.com/zh-TW/cloud-services/Subsystems/Hub/Content/Sense_Hub/AutoML/analyze-models-detailed.htm)