# Replication 设置

可以配置复制数据任务的设置。

* 打开复制任务，然后单击工具栏中的设置。

设置：&lt;任务名称&gt; 对话框打开。可用设置如下所述。

## 一般

在此选项卡中，您可以更改复制模式、暂存设置（如果可用）、将更改应用于目标的模式以及发布设置。

### Replication 模式

有以下复制模式可用：

* 完全加载： 将数据从选定的源表加载到目标平台，并在必要时创建目标表。当任务启动时，满负载会自动发生，但如果需要，也可以手动执行。例如，如果需要复制视图的更新（CDC 期间不会捕获视图更新），或者从不支 持 CDC 的数据源进行复制，则需要手动满负载。

  信息注释当使用 SaaS 应用程序连接器时，此选项将始终启用，因为需要满负载。

* 应用更改： 使目标表更新对源表所做的任何更改。

* 存储更改： 将对源表的更改存储在“更改表”中（每个源表一个）。

  有关更多信息，请参阅[存储更改](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm#Store)。

使用 数据移动网关 时，除了使用 SaaS 应用程序源，更改会从源几乎实时地捕获。当不使用 数据移动网关 工作时（例如，使用 Qlik Talend Cloud Starter 订阅或选择 无 时）或使用 SaaS 应用程序源时，将根据调度程序设置捕获更改。有关更多信息，请参阅[Scheduling tasks](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Deploying/Scheduling-tasks.htm)。

信息注释

如果您选择 存储更改 或 应用更改，且您的数据源：

* 不是 SaaS 应用程序

* 包含支持 CDC 的数据集以及仅支持全量加载的数据集（例如视图）

将创建两个数据管道。将为支持 CDC 的表创建一个管道，并为仅支持全量加载的数据集创建另一个管道。

### 加载方法

复制到 Snowflake 时，您可以选择以下加载方法之一：

* 批量加载（默认）

  如果选择批量加载，则可以在数据上传选项卡中调整加载参数。

* Snowpipe Streaming

  信息注释

  Snowpipe 数据流只有在满足以下条件时才可供选择：

  * 已启用存储更改复制模式，但不应用更改。
  * Snowflake 连接器中的验证机制设置为密钥对。
  * 如果使用 数据移动网关 ，则需要 2024.11.45 或更高版本。

  如果您选择 Snowpipe 数据流，请确保您熟悉使用此方法时的[限制和注意事项](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/snowflake-target.htm#Limitati2)。此外，如果选择 Snowpipe 数据流，然后启用应用更改复制模式或禁用存储更改，加载方式将自动切换回批量加载。

选择 Snowpipe 数据流而非批量加载的主要原因是：

* 成本更低：由于 Snowpipe 数据流不使用 Snowflake 仓库，因此运营成本应大大降低，但这取决于您的具体使用情况。

* 减少延迟： 由于数据直接流向目标数据表（而不是通过暂存），因此从数据源复制到目标数据表的速度应该更快。

提示注释使用 Snowpipe 数据流时，初始满负载可能会比批量加载慢很多。为了优化加载性能，尤其是在加载大型数据集时，最佳做法是将 Snowpipe 数据流 与[并行加载特性](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/Table-settings-replication.htm)结合使用。

### 连接到暂存区域

当复制到下面列出的数据仓库时，您需要设置一个暂存区域。数据在转移到仓库之前在暂存区进行处理和准备。

* [Amazon Redshift](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/redshift-target.htm)
* [Microsoft Fabric](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/fabric-target.htm)
* [Databricks](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/databricks-target.htm)

选择现有暂存区域，或单击新建以定义新的暂存区域，然后按照[连接至云存储](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/cloud-storage-connections.htm)中的说明进行操作。

要编辑连接设置，请单击编辑。要测试连接（推荐），请单击测试连接。

有关哪些数据仓库支持哪些暂存区域的信息，请参阅中的支持作为暂存区[目标平台用例和支持的版本](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/data-project-connections.htm#ar_app_supported_dbversions_993761142_cjaehbcc)列。

### 应用更改模式

信息注释在复制到数据仓库目标或使用 Qlik Talend Cloud Starter 订阅工作时，您无法选择要使用的应用更改模式。更改将始终应用于批量优化模式，以获得最大效率。但复制到 Snowflake 目标且加载方法设置为 Snowpipe 数据流时除外。在这种情况下，虽然仍无法选择使用哪种应用更改模式，但更改将始终在事务性模式下应用。

使用以下方法之一将更改应用于目标表：

* 批量优化：这是默认设置。选择此选项后，将分批应用更改。进行预处理操作，以最有效的方式将事务分组为批。
* 事务性：选择此选项可以按照提交的顺序单独应用每个事务。在这种情况下，可以确保所有表都具有严格的引用完整性。

### 发布设置

* 发布至目录

  选择此选项可将此版本的数据作为数据集发布到目录。目录内容将在下次准备此任务时更新。

  有关目录的更多信息，请参阅[通过目录工具理解您的数据](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/Catalog/catalog-overview.htm)。

### 使用 数据移动网关 时的代理设置

* 使用 Data Movement gateway 时，通过代理连接到

  使用 数据移动网关 时，您可以通过代理连接到目标平台和暂存平台（区域）。

  有关配置 数据移动网关 以使用代理服务器的详细信息，请参阅 [设置 Qlik Cloud 租户和代理服务器](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/Gateways/dm-gateway-setting-up.htm#Setting)。

  * 使用数据移动网关时的代理服务器

    选择此选项以使用为 数据移动网关 配置的代理服务器。

  * 目标平台

    信息注释在使用 Snowflake 和 Databricks 时可用。

  * 暂存平台

    信息注释在使用 Google BigQuery、Amazon Redshift、Microsoft Fabric 和 Databricks 时可用。

## 数据上传

此选项卡仅在复制到数据仓库或 Kafka 目标时显示。此外，此选项卡中的设置将根据所选目标而有所不同。

###

### 与所有数据仓库目标相关

最大文件大小

文件在关闭之前可以达到的最大大小。与并行执行选项结合使用时，较小的文件可能会上传得更快（取决于网络），并提高性能。然而，通常认为用小文件扰乱数据库是不好的做法。

### 仅适用于 Snowflake 目标

在常规选项卡中，您可以选择使用批量加载或 Snowpipe 数据流将数据加载到 Snowflake。选择 Snowpipe 数据流时，将不显示数据上传选项卡。选择批量加载后，可进行以下设置：

* 最大文件大小 (MB)：适用于初始全量加载和 CDC。文件在加载到目标之前可以达到的最大大小。如果遇到性能问题，请尝试调整此参数。

* 每个批次加载的文件数： 仅适用于初始全量加载。单个批次中要加载的文件数量。如果遇到性能问题，请尝试调整此参数。

有关批量加载和 Snowpipe 数据流加载方法的说明，请参阅[一般](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm#General) 。

### 仅适用于 Teradata 目标

当 Teradata 为目标时，在复制任务中配置这些设置。

#### 基本设置

* TPT 操作符：选择 Load 或 Stream。默认值为 Stream。
* JSON 格式：选择 文本、BSON 或 UBJSON。默认值为 文本。

#### TPT 操作符模式

TPT 操作符决定了如何将数据写入 Teradata。

* Stream（默认）：使用 Teradata TPump 协议以准实时方式执行高速 DML 事务。在执行 DML 操作的同时，可以查询表。该模式对持续变更处理的限制较少。当源支持此运算符时，数据库用户可能还需要 `CREATE MACRO` 权限。

* 加载：使用 Teradata FastLoad 协议将大量数据加载到空表中。目标表必须为空，且不能有二级索引。仅当这些限制符合任务的处理要求时，才使用此模式。

#### JSON 格式选项

指定 JSON 列在 Teradata 中的存储方式：

* 文本（默认）：将 JSON 数据存储为文本。
* BSON：以 BSON 格式存储 JSON 数据。
* UBJSON：以 UBJSON 格式存储 JSON 数据。

#### 高级 TPT 属性

在 TPT 属性下，配置以下选项：

* 缓冲区大小：设置用于向 Teradata 发送加载数据包的输出缓冲区大小。输入 1 到 64 KB 之间的值。
* 缓冲区：设置使用的请求缓冲区数量。输入 2 或更大的值。
* 显式会话范围：设置可登录到 Teradata 的最小和/或最大会话数。
  * 最大值：设置最大会话数。该值不能超过可用访问模块处理器 (AMP) 的数量。
  * 最小值：设置最小会话数。
* 动态语句打包：选择此选项可让数据流驱动程序确定当前数据流作业的最大可能打包量。
* 语句打包：设置在 Stream 模式下打包到多语句请求中的语句数量。请输入 2 到 600 之间的值。当未选择动态语句打包时，此选项可用。

### 仅适用于 Kafka 目标

#### 消息属性

压缩

（可选）选择一种可用的压缩方法（Snappy 或 Gzip）。默认值为 无。

#### 数据消息发布

选择以下其中一个将数据发布到选项：

* 特定主题：将数据发布到单个主题。输入主题名称或使用浏览按钮选择所需主题。

* 为每个表使用单独主题：将数据发布到与源表名称相对应的多个主题。

  目标topic名称由源架构名称和源表名称组成，用句点分隔（例如，dbo.Employees）。目标topic名称的格式很重要，因为您需要提前准备这些topic。

信息注释

如果主题不存在，请配置代理，使其具有 `auto.create.topics.enable=true`，以使数据任务能够在运行时创建主题。否则，任务将失败。

有关在数据集级别覆盖此设置的信息，请参阅 [发布到 Kafka 时覆盖单个数据集的任务设置](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/kafka-dataset-settings.htm)

消息键

选择一个可用选项。

* 主键列：对于每条消息，消息键将包含主键列的值。

  当按消息键被选为分区策略时，由相同主键值组成的消息将被写入同一分区。

* 架构和表名：对于每条消息，消息键将包含架构和表名的组合（例如，dbo+Employees）。

  当按消息键被选为分区策略时，由相同架构和表名组成的消息将被写入同一分区。

* 无：创建不带消息键的消息。

有关在数据集级别覆盖此设置的信息，请参阅 [发布到 Kafka 时覆盖单个数据集的任务设置](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/kafka-dataset-settings.htm)

分区策略

选择随机或按消息键。如果选择随机，则每条消息将写入随机选择的分区。如果选择按消息键，则消息将根据所选的消息键 （如上所述）写入分区。

#### 元数据消息发布

信息注释使用 JSON 消息格式时，不需要发布数据模式。

主题名称策略

信息注释

第一个策略 (架构和表名) 是专有的 Qlik 策略，而其他三个是标准的 Confluent 主题名称策略。

选择一个可用的主题名称策略。

* 架构和表名 (默认)
* 主题名称
* 记录名称
* 主题和记录名称

有关 Confluent 主题名称策略的更多信息，请参阅 [主题名称策略](https://docs.confluent.io/platform/current/schema-registry/serdes-develop/index.html#subject-name-strategy)

主题兼容模式

从 主题兼容模式 下拉列表中选择以下兼容模式之一：

* 使用 Schema Registry 默认值：从 Schema Registry 服务器配置中检索兼容性级别。

* 向后兼容 - 仅最新模式：新模式只能读取相应数据以及由最新注册的模式生成的数据。

* 向后传递 - 所有先前的模式：新模式可以读取所有先前已注册模式生成的数据。

* 向前 - 仅限最新模式： 最新注册的模式可以读取新模式生成的数据。

* 前向传递 - 所有先前 Schema：所有先前注册的 Schema 均可读取由新 Schema 生成的数据。

* 完全 - 仅限最新模式：新模式与最新注册的模式向后和向前兼容。

* 完全传递 - 所有先前模式：新模式与所有先前注册的模式向后和向前兼容。

* 无

信息注释

* 根据所选的主题名称策略，某些兼容模式可能不可用。

* 将消息发布到架构注册表时，所有新创建的*控制表主题*的默认主题兼容模式将为无，无论所选的主题兼容模式如何。

  如果您希望所选的主题兼容模式也适用于控制表，请将 Kafka 目标连接器中的内部参数setNonCompatibilityForControlTables设置为false。

使用代理连接到 Confluent 架构注册表

信息注释

此选项仅在发布到 Confluent Schema Registry 时受支持。

如果您的 数据移动网关 配置为使用代理服务器，请开启此选项。

#### 消息属性

您可以指定将覆盖默认消息属性的自定义消息属性。如果消费者应用程序需要以特定格式处理消息，这很有用。

自定义消息属性可以在任务级别和表级别定义。当属性在任务 *和* 表级别都定义时，为表定义的消息属性将优先于为任务定义的消息属性。

有关在数据集级别覆盖消息属性的信息，请参阅 [发布到 Kafka 时覆盖单个数据集的任务设置](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/kafka-dataset-settings.htm)

信息注释

不支持分层结构化消息。

一般规则和使用指南

定义自定义消息时，务必考虑下面列出的规则和使用指南。

节名称

以下命名规则适用：

* 节名称必须以字符 a-z、A-Z 或 \_（下划线）开头，之后可以跟以下任意字符：a-z、A-Z、0-9、\_

* 除了记录名称和键名称部分（不以斜杠结尾）之外，从节名称中删除斜杠将扁平化关联部分的层级（请参阅下面的斜杠）。

* 除了记录名称和键名称之外的所有节名称都可以删除（请参阅下面的删除）

* 数据名称和包含记录前数据部分名称不能同时删除

* 数据名称和包含记录前数据部分名称不能相同

[](https://help.qlik.com/en-US/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm)斜杠

UI 中的某些部分名称以斜杠结尾（例如`beforeData/`). 斜杠的目的是为了维护消息中不同部分的层级结构。如果斜杠被移除，将发生以下情况：

* 该部分的层级结构将被扁平化，导致部分名称从消息中移除
* 部分名称将作为前缀添加到实际元数据，直接添加或使用您附加到名称的分隔符（例如下划线）

当 `headers/` 指定为斜杠时的数据消息示例：

```
		"message":{
		        "data":{
			      "COL1": "159",
			      "COL2": "159"
                       },
                       "beforeData": null,
		        "headers": {
			"operation": "INSERT",
			"changeSequence": "2018100811484900000000233",
```

当 `headers_` 指定为下划线而不是斜杠时的数据消息示例：

```
		"message":{
		        "data":{
			      "COL1": "159",
			      "COL2": "159"
                       },
                       "beforeData": null,                     
                       "headers_operation": "INSERT",
			"headers_changeSequence": "2018100811484900000000233",
```

[](https://help.qlik.com/en-US/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm)删除

从消息中删除部分名称将扁平化该部分的层级结构。This will result in all of that section's data appearing immediately below the content of the preceding section.

Example of a data message with the ` headers  `section name:

```
	        "message":{
		        "data":{
			      "COL1": "159",
			      "COL2": "159"
                       },
		        "headers": {
			"operation": "INSERT",
			"changeSequence": "2018100811484900000000233",
```

Example of a data message without the ` headers  `section name:

```
	        "message":{
		        "data":{
			      "COL1": "159",
			      "COL2": "159"
                       },
                       "beforeData": null,                   
                       "operation": "INSERT",
			"changeSequence": "2018100811484900000000233",
```

变量

You can add variables to names by clicking the ![](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Resources/Images/Replicate/fx_icon_12x14.png) button at the end of the row.The following variables are available:

* SERVER\_NAME - 数据移动网关 服务器的主机名
* TARGET\_TABLE\_NAME - 表的名称
* TARGET\_TABLE\_OWNER - 表所有者
* TASK\_NAME - 数据任务的名称

信息注释

TARGET\_TABLE\_OWNER 变量不适用于记录名称和键名称选项（如下表所述）。

定义自定义消息属性

要定义自定义消息格式，请开启使用自定义设置并配置下表中描述的选项。

要恢复默认消息属性，请关闭使用自定义设置。

消息格式选项

| 选项 | 描述 |
| --- | --- |
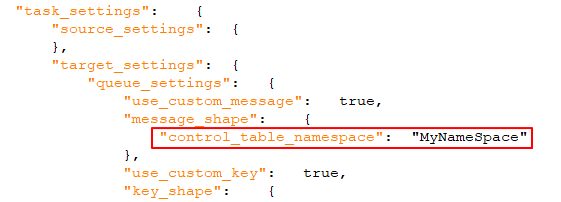
| [](https://help.qlik.com/en-US/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm)包含命名空间 | 开启时（默认），消息中将包含一个唯一标识符。这应该是一个字符串，用句点分隔。请注意，命名空间将同时包含在消息和消息密钥中。<br><br>：<br><br>mycompany.queue.msg<br><br>默认名称：<br><br>com.attunity.queue.msg.{{TASK\_NAME}}.{{TARGET\_TABLE\_OWNER}}.{{TARGET\_TABLE\_NAME}}<br><br>控制表的默认名称：<br><br>com.attunity.queue.msg.{{TARGET\_TABLE\_NAME}}<br><br>信息注释<br><br>默认控制表命名空间无法通过UI更改。但是，您可以按如下方式更改默认控制表命名空间：<br><br><ol> <li>在任务设置<span>消息格式</span>选项卡中，单击<span>自定义消息格式</span>按钮，然后单击<span>确定</span>。</li> <li>保存任务，然后使用<span>导出任务</span>工具条形按钮导出它。</li> <li> <p>打开导出的 JSON 文件并添加 <code>control_table_namespace</code> 参数，如下所示（将 <code>MyNameSpace</code> 替换为您自己的值）：</p> <p> <img src="https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Resources/Images/Replicate/kafka_json.png" alt="JSON 文件导出示例，其中“control_table_namespace”字段已突出显示"> </p> </li> <li>保存 JSON 文件，然后使用 <span>导入任务</span> 工具栏按钮将其导入到 Replicate。</li> </ol> |
| 记录名称 | 记录（消息）的名称。<br><br>默认名称：<br><br>DataRecord |
| 数据名称 | 记录中包含的所有数据列。<br><br>默认名称：<br><br>数据/ |
| 包括标题 | 启用时（默认），消息中将包含标头列。标题列提供有关源操作的额外信息。<br><br>有关更多信息，请参阅下方的“包含以下标题”。 |
| 包含标头命名空间 | 启用时（默认），消息中将包含标题列部分的唯一标识符。这应该是一个字符串，用句点分隔。<br><br>示例：<br><br>headers.queue.msg<br><br>默认名称：<br><br>com.attunity.queue.msg |
| 标题名称 | 包含 Qlik 列标题的部分的名称。<br><br>默认名称：<br><br>标题/ |
| [](https://help.qlik.com/en-US/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm)包含的邮件头 | 有关可用标题列的说明，请参阅 Qlik 帮助中的数据消息。<br><br>默认设置：<br><br>默认情况下，所有列都包括在内，但 外部架构 ID 列除外。 |
| 在数据之前包含记录 | 启用时（默认），更新前和更新后的数据都将包含在更新消息中。<br><br>若要在消息中仅包含更新后的数据，请关闭此选项。<br><br>默认名称：<br><br>之前数据/ |
| 密钥名称 | 包含消息键的部分的名称。<br><br>默认名称：<br><br>keyRecord<br><br>此选项仅在以下情况适用：<br><br><ul> <li>消息格式为<span>Avro</span>。</li> <li><span>元数据发布方法</span>设置为<span>将数据架构发布到 Confluent Registry Schema</span>或<span>将数据架构发布到 Hortonworks Schema Registry</span></li> <li><span>消息键</span>未设置为<span>无</span></li> </ul> |

#### 其他设置

* 消息最大大小

  在消息最大大小字段中，指定代理配置为接收的消息的最大大小 (`message.max.bytes`)。数据任务不会发送大于最大大小的消息。

## 元数据

### 基本

* 目标表模式

  如果不想使用源表模式（或者源数据库中没有模式），则为源表将复制到的目标上的模式。

  信息注释当复制到 Oracle 目标时，默认的目标表架构是“系统”。还要注意，如果将此字段留空（在这种情况下将使用源架构），则必须确保源架构已存在于目标上。否则，任务将失败。

  信息注释模式名称允许的最大长度为 128 个字符。

#### JSON 列映射

将兼容的源 JSON 列映射到目标上的 JSON 列

信息注释

* 如果您使用 数据移动网关 访问数据源，则需要版本 2024.11.70 或更高版本。

选中此选项后，源上的 JSON 列将自动映射到目标上的 JSON 列。

此选项的状态和可见性由以下因素决定：

* 新任务： 如果源和目标都支持 JSON 数据类型，则此选项将默认启用。

* 现有任务： 即使源和目标都支持 JSON 数据类型，此选项也将默认禁用。这是为了保持与下游流程（例如转换）的向后兼容性，这些流程期望目标数据为 STRING 格式（这是传统行为）。您可以禁用该选项，也可编辑下游进程以兼容 JSON 格式，然后启用该选项。

* 新建和现有任务： 如果只有源支持 JSON 数据类型，此选项将不可见。如果稍后在目标中添加 JSON 支持，该选项将变为可见，但仍处于禁用状态。这是为了保持与下游流程（例如转换）的向后兼容性，这些流程期望目标数据为 STRING 格式（这是传统行为）。

#### LOB 设置

信息注释这些设置不适用于使用 SaaS 应用程序连接器的任务。

可用的 LOB 设置因所选复制目标而异。由于数据仓库目标不支持无限制的 LOB 列大小，因此在复制到数据仓库时，此选项将不可用。

非数据仓库的目标的 LOB 设置

* 不包括 LOB 列：如果不希望复制源 LOB 列，请选择此选项。

* 将 LOB 列大小限制为 (KB)：这是默认设置。如果您只需要复制小型 LOB，或者目标平台不支持无限制的 LOB 大小，请选择此选项。此字段允许的最大值为 102400 KB (100 MB)。

  在复制小型 LOB 时，此选项比不限制 LOB 列大小选项更高效，因为 LOB 是“内联”复制的，而不是通过从源“查找”来复制的。在更改处理过程中，通常通过从源“查找”来复制小型 LOB。

  该限制适用于从源终结点读取的 LOB 字节数。对于 BLOB 列，目标 BLOB 大小将完全依据指定的限制。对于 CLOB 和 NCLOB 列，如果源和目标 LOB 没有相同的字符集，则目标 LOB 大小可能与指定的限制不同。在这种情况下，数据任务将执行字符集转换，这可能会导致源和目标 LOB 大小之间的差异。

  由于限制 LOB 大小为的值以字节为单位，因此应根据以下公式计算大小：

  * BLOB：最大 LOB 的长度。
  * NCLOB：以字符为单位的最长 TEXT 的长度乘以 2（因为每个字符都作为双字节处理）。如果数据包含 4 字节字符，请将其乘以 4。
  * CLOB：以字符为单位的最长 TEXT 的长度（因为每个字符都作为 UTF8 字符处理）。如果数据包含 4 字节字符，请将其乘以 4。

  信息注释

  * 任何大于指定大小的 LOB 都将被截断。
  * 在 Oracle 源代码的更改处理过程中，内联 BLOB 会以内联方式复制。
  * 对此设置的更改只会在重新加载现有表后影响这些表。

* 不限制 LOB 列大小：选中此选项时，无论大小如何，都将复制 LOB 列。

  信息注释复制 LOB 列可能会影响性能。在大型 LOB 列需要复制任务从源表执行查找以检索源 LOB 值的情况下尤其如此。

  * 在 LOB 大小小于以下值时进行优化： 当您需要同时复制小型和大型 LOB，并且大多数 LOB 都是小型 LOB 时，请选择此选项。

    信息注释

    仅以下源和目标支持此选项：

    * **源：**Oracle、Microsoft SQL server、MySQL、PostgreSQL 和 IBM DB2 for LUW

    * **目标：** Oracle, Microsoft SQL Server, MySQL, PostgreSQL。

    选择此选项后，在满负载期间，将“内联”复制小型 LOB（效率更高），而大型 LOB 将通过从源表执行查找来复制。但是，在更改处理期间，将通过从源表执行查找来复制小型和大型 LOB。

    信息注释

    选择此选项后，复制任务将检查所有 LOB 大小，以确定要“内联”传输的 LOB。将使用完整 LOB 模式复制大于指定大小的 LOB。

    因此，如果您知道大多数 LOB 都大于指定的设置，则最好改用 **Replicate 无限制 LOB 列** 选项。

  * 块大小 (KB)：也可以更改将数据复制到目标时要使用的 LOB 块的大小。在大多数情况下，默认的区块大小应该足够，但如果遇到性能问题，调整大小可能会提高性能。

    信息注释

    对于某些数据库，在插入或更新数据时会进行数据类型验证。在此类情况下，结构化数据类型的复制（例如XML、JSON、GEOGRAPHY 等），如果数据大于指定的块大小，则可能会失败。

支持的数据仓库目标的 Lob 设置

* 包括 LOB 列并将列大小限制为 (KB)：

  您可以选择在任务中包括 LOB 列，并设置最大 LOB 大小。大于最大大小的 LOB 将被截断。

### 高级

#### 控制表设置

* 控制表模式：如果您不希望在源模式（默认）或目标模式中创建控制表，请指定控制表的目标模式。

  信息注释模式名称允许的最大长度为 128 个字符。

* 在表空间中创建目标控制表：当目标复制目标是 Oracle 时，指定要在其中创建目标控制表的表空间。如果您没有在该字段中输入任何信息，那么表将在目标数据库的默认表空间中创建。

* 为表空间中的目标控制表创建索引：当复制目标是 Oracle 时，指定要在其中创建控制表索引的表空间。如果不在此字段中输入任何信息，则索引将在与控制表相同的表空间中创建。

* 复制历史时间段（分钟）：[复制历史记录](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replication_history.htm) 控制表中每个时间段的长度。默认值为 5 分钟。

#### 控制表选择

选择要在目标平台上创建的控制表：

| 逻辑名称 | 目标中名称 |
| --- | --- |
| 应用例外 | attrep\_apply\_exceptions |
| 复制状态 | attrep\_status |
| 挂起的表 | attrep\_suspended\_tables |
| 复制历史记录 | attrep\_history |
| DDL 历史 | attrep\_ddl\_history<br><br>DDL 历史记录表仅受以下目标平台的支持：<br><br><ul> <li> <p>Databricks</p> </li> <li>Microsoft Fabric</li> <li>Amazon Redshift</li> <li>如果您正在使用 <span>数据移动网关</span>，以下目标需要 2024.11.14 或更高版本:<ul><li>Amazon S3</li><li>Google Cloud Storage</li><li>Snowflake</li></ul></li> <li>Kafka - 如果使用 <span>数据移动网关</span>，则需要 2025.5.42 或更高版本。</li> <li>如果您正在使用 <span>数据移动网关</span>，以下目标需要 2025.11.1 或更高版本:<ul><li>Google BigQuery </li><li>Google Cloud Alloy DB for PostgreSQL（通过 PostgreSQL 连接器）</li><li>Google Cloud SQL for PostgreSQL（通过 PostgreSQL 连接器）</li><li>Microsoft Azure Database for PostgreSQL（通过 PostgreSQL 连接器）</li><li>PostgreSQL</li></ul></li> </ul> |

有关控制表的更多信息，请参阅[控制表](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/control_tables.htm)。

## 满负载

### 基本

这些设置将在数据任务准备阶段以及每次重新加载表时应用。

如果目标表已经存在： 选择以下选项之一，以确定应该如何将数据加载到目标表：

信息注释

只有当源端点支持删除或截断目标表的操作时，删除或截断这些表的选项才相关。

* 删除并创建表： 删除目标表，并在其位置创建一个新表。

  信息注释

  将不会删除复制任务控制表。但是，如果重新加载关联的任务，则也将从 [attrep_suspended_tables](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/suspended_tables.htm) 控制表中删除所放弃的任何挂起的表。

* 加载前 TRUNCATE：在不影响目标表元数据的情况下截断数据。请注意，如果选择此选项，启用[在满负载完成后创建主键或唯一索引](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm#pk-create)选项将无效。

  信息注释当 Microsoft Fabric 是目标平台时不受支持。

* 忽略：目标表的现有数据和元数据不会受到影响。新数据将添加到表中。

### 高级

#### 性能调整

信息注释这些设置不适用于使用 SaaS 应用程序连接器的任务。

如果数据复制速度过慢，调整以下参数可能会提高性能。

* 表的最大数量：立刻输入要加载到目标中的最大表数。默认值为 5。

* 事务一致性超时（秒）：输入在开始满负载操作之前复制任务应当等待打开的事务关闭的秒数。默认值为 600（10 分钟）。即使存在打开的事务，复制任务也将在达到超时值后开始满负载。

  信息注释要复制在满负载开始时打开但在达到超时值后才提交的事务，需要重载目标表。

* 满负载期间的提交速率：可以一起传输的最大事件数。默认值为 10000。

#### 在满负载完成之后

您可以将任务设置为在满负载完成后自动停止。如果您需要在任务的“应用更改”（即CDC) 阶段开始。

在满负载期间，对源表执行的任何 DML 操作都会被缓存。当满负载完成时，缓存的更改将自动应用于目标表（只要以下所述的应用缓存更改之前/之后选项处于禁用状态）。

* [](https://help.qlik.com/en-US/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm)创建主键或唯一索引： 如果您希望在满负载完成之后再在目标上创建主键或唯一索引，请选择此选项。

  信息注释此设置不适用于使用 SaaS 应用程序连接器的任务。

* 停止任务

  信息注释

  复制到数据仓库目标时，这些设置不可用。

  * 在应用缓存的更改之前：选择在全量加载完成后停止任务。

  * 应用缓存的更改后：选择此项可在任务中所有表的数据保持一致后立即停止任务。

  信息注释

  将任务配置为在满负载完成后停止时，请注意以下事项：

  * 任务不会在满负载完成时停止。只有在捕捉到第一批更改后，它才会停止（因为这是触发任务停止的原因）。这可能需要一段时间，具体取决于源数据库的更新频率。任务停止后，在恢复任务之前，更改不会应用于目标。
  * 选择在应用缓存的更改之前可能会影响性能，因为缓存的更改将仅在最后一个表完成“满负载”之后应用于表（甚至是那些已经完成“满负载”的表）。
  * 如果选择此选项，并且在满负载过程中（在满负载和应用更改任务中）对其中一个源表执行 DDL，则复制任务会重新加载该表。这实际上意味着在源表上执行的任何 DML 操作都将在任务停止之前复制到目标。

#### 对于初始加载

信息注释这些设置不适用于使用 SaaS 应用程序连接器的任务。

信息注释如果您使用 数据移动网关 访问您的数据源，则这些设置需要 2022.11.74 或更高版本。

| 使用缓存数据 | 此选项允许您使用在选择完整数据扫描的情况下生成元数据时读取的缓存数据。<br><br>这减少了 API 使用和配额方面的开销，因为已经从源读取数据。自初始数据扫描以来的任何更改都可以通过更改数据捕获 (CDC) 获取。 |
| --- | --- |
| 从源加载数据 | 此选项从数据源执行新加载。此选项在以下情况下很有用：<br><br><ul> <li> <p>最近未执行元数据扫描。</p> </li> <li> <p>源数据集很小并且经常更改，而您不希望维护完整的更改历史记录。</p> </li> </ul> |

## 应用更改

这些设置仅在启用应用更改复制模式时可用。

### 基本

#### 选择要应用于目标的 DDL 更改的类型

信息注释从 SaaS 应用程序源进行复制时，这些设置不可用。

以下选项确定对相应源表执行的 DDL 操作是否也将对目标表执行。

* 删除表： 选中此项可在删除源表时删除目标表。

  信息注释当 Kafka 是目标平台时不受支持。

* 截断表： 选择此项可在源表被截断时截断目标表。

  信息注释当 Microsoft Fabric 是目标平台时不受支持。

* 修改表：选中此项可在源表被修改时修改目标表。

  信息注释当 Kafka 是目标平台时，不支持重命名表。

#### 更改处理调谐

* 将批处理更改同时应用于多个表：在应用来自多个源表的更改时，选择此选项可能会提高性能。

  信息注释

  只有在以下情况下才支持此选项：

  * 将应用更改模式设置为批量优化。有关更多信息，请参阅[Replication 设置](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm#Replicat)。
  * 复制目标不是 MySQL、PostgreSQL、Oracle 和 Google BigQuery。

  * 最大表数量：并发应用批量更改的最大表数量。默认值为 5，最大值为 50，最小值为 2。

    启用同时对多个表应用批处理更改选项时，将应用以下限制：

    * 环境和表错误的任务错误处理策略默认值将保持不变，但数据错误和应用冲突错误的默认值如下：

      * 数据错误：
        * 数据截断错误：将记录记载到异常表
        * 其他数据错误： 挂起表
      * 应用冲突错误：
        * 删除： 忽略记录

        * 插入： 将现有目标记录 UPDATE

          信息注释这与 Snowflake 目标无关（因为 Snowflake 不支持主键）。

        * 更新： 忽略记录
      * 升级操作：
        * 不支持针对数据错误和应用冲突的升级操作。
      * [attrep_apply_exception](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/apply_exceptions.htm) 控制表不受支持。
      * 对于数据错误：
        * 将记录记载到异常表选项仅适用于数据截断错误。
        * 没有忽略选项。
      * 对于应用冲突：
        * 将记录记载到异常表选项不可用。

        * 忽略选项仅适用于未找到应用 UPDATE 的记录应用冲突。

    另请参阅：[错误处理](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm#Error)。

* 将每个变更处理语句应用的变更数限制为： 要限制在单个变更处理语句中应用的变更数，请选中此复选框，然后可根据需要更改默认值。默认值为 10,000。

  信息注释仅以下目标支持此选项：MySQL、PostgreSQL、Oracle 和 Google BigQuery。

### 高级

请参阅 [更改处理调谐](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm#Change)。

## 存储更改

只有在启用存储更改复制模式时，这些设置才可用。

### 基本

#### DDL 选项

信息注释从 SaaS 应用程序源进行复制时，这些设置不可用。

选择以下选项之一以确定如何处理源表上的 DDL 操作：

* 应用于更改表：对源表的 DDL 操作（例如正在添加的列）将仅应用于相应的更改表。
* 忽略：将忽略对源表的所有 DDL 操作。

### 高级

#### 在更新

信息注释此设置与 SaaS 应用程序源无关，因为更改是作为 INSERT 操作应用的。

选择存储前后图像以存储 UPDATE 前数据和 UPDATE 后数据。如果未选中，则只存储更新后的数据。

#### 更改表创建

以下部分介绍了在“更改表”中存储变更时可用的选项。

* 后缀：指定一个用作所有变更表后缀的字符串。默认值为 \_\_ct。更改表名称是附加了后缀的目标表的名称。例如，使用默认值，变更表的名称将为 HR\_\_ct。
* 表头列前缀：指定一个字符串，用作所有变更表表头列的前缀。默认值为 header\_\_。例如，当使用默认值时，标题列 stream\_position 将被称为 header\_\_stream\_position。

有关更改表的详细信息，请参阅[使用更改表](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/use_change_tables.htm)。

如果满负载启动时存在更改表：选择以下选项之一，以确定在开始满负载复制时如何加载更改表：

* 放置和创建更改表格：将删除该表，并在其位置创建一个新表。

* 删除旧更改并将新更改存储在现有更改表中：在不影响表元数据的情况下截断和添加数据。

  信息注释当 Microsoft Fabric 是目标平台时不受支持。

* 保留旧更改并将新更改存储在现有更改表中：现有更改表的数据和元数据不受影响。

#### 表头列

更改表头列提供有关更改处理操作的信息，如操作类型（例如 INSERT）、提交时间等。如果不需要所有此类信息，可以配置 移动 任务以创建具有选定表头列（或根本没有表头列）的更改表，从而减少它们在目标数据库中的占用空间。

信息注释在任务运行时，不能删除其他列或还原列。要更改初始选择，首先需要停止任务，然后修改选择，最后重新加载目标表。

有关表头列的说明，请参阅[更改表格](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/read_change_tables.htm)。

## 错误处理

### 基本

#### 应用冲突

应用 INSERT 时出现重复键：选择与 INSERT 操作发生冲突时要采取的操作。

信息注释从 SaaS 应用程序源进行复制时，只支持将现有目标记录 UPDATE 操作。

* 忽略：任务将继续，并忽略该错误。

* 将现有目标记录 UPDATE：更新与 INSERTED 源记录具有相同主键的目标记录。

* 将记录记录到异常表（默认值）：任务将继续，错误将写入异常表。

* 挂起表：任务将继续，但带有错误记录的表中的数据将移动到错误状态，并且不会复制其数据。

* 停止任务：任务已停止，需要手动干预。

未找到应用 UPDATE 的记录： 选择在 UPDATE 操作发生冲突时要采取的操作。

信息注释从 SaaS 应用程序源进行复制时，仅支持 插入缺失的目标记录 操作。

* 忽略：任务将继续，并忽略该错误。

* [](https://help.qlik.com/en-US/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm)插入 (INSERT) 丢失的目标记录：丢失的目标记录将插入到目标表中。当源端点为 Oracle 时，选择此选项需要为所有源表列启用补充日志记录。

* 将记录记录到异常表（默认值）：任务将继续，错误将写入异常表。

* 挂起表：任务将继续，但带有错误记录的表中的数据将移动到错误状态，并且不会复制其数据。

* 停止任务：任务已停止，需要手动干预。

### 高级

信息注释

数据错误处理仅在“应用更改”复制模式下受支持（而不是“满负载”）。

#### 数据错误

对于数据截断错误：选择在一个或多个特定记录中发生截断时要执行的操作。您可以从列表中选择以下选项之一：

* 忽略：任务将继续，并忽略该错误。
* 将记录记录到异常表（默认）：任务继续进行，并将错误写入异常表。
* 挂起表：任务继续进行，但带有错误记录的表中的数据会移动到错误状态，并且不会复制其数据
* 停止任务：任务已停止，需要手动干预。

对于其他数据错误：选择在一个或多个特定记录中发生错误时要执行的操作。您可以从列表中选择以下选项之一：

* 忽略：任务将继续，并忽略该错误。
* 将记录记录到异常表（默认）：任务继续进行，并将错误写入异常表。
* 挂起表：任务继续进行，但带有错误记录的表中的数据会移动到错误状态，并且不会复制其数据
* 停止任务：任务已停止，需要手动干预。

当其他数据错误达到时，升级错误处理（每个表）：选中此复选框，当非截断数据错误（每个表）数量达到指定数量时，将错误处理升级。有效值为 1-10,000。

升级操作：选择升级错误处理时应执行的操作。请注意，可用的操作取决于从上述针对其他数据错误下拉列表中选择的操作。

* 挂起表（默认值）：任务将继续，但带有错误记录的表中的数据将移动到错误状态，并且不会登陆其数据。

  信息注释

  行为因更改处理模式而异：

  * 在事务应用模式中，不会登陆上次的更改。

  * 在批量优化应用模式中，可能出现数据根本不会登陆或仅部分登陆的情况。

* 停止任务：任务已停止，需要手动干预。

* 将记录记录到异常表：任务将继续，记录将写入异常表。

#### 表格错误

遇到表格错误时：从下拉列表中选择以下选项之一：

* 挂起表（默认）：任务将继续，但带有错误记录的表中的数据将移动到错误状态，并且不会复制其数据。
* 停止任务：任务已停止，需要手动干预。

当表格错误达到时，升级错误处理（每个表）：选中此复选框，当表格错误（每个表）数量达到指定数量时，将错误处理升级。有效值为 1-10,000。

升级操作：表错误的升级策略设置为停止任务，无法更改。

#### 应用冲突

信息注释从 SaaS 应用程序源进行复制时，这些设置不可用。

[](https://help.qlik.com/en-US/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm)找不到应用 DELETE 的记录：选择与 DELETE 操作发生冲突时要执行的操作。

* 忽略：任务将继续，并忽略该错误。
* 将记录记录到异常表：任务将继续，记录将写入异常表。
* 挂起表：任务将继续，但带有错误记录的表中的数据将移动到错误状态，并且不会复制其数据。
* 停止任务：任务已停止，需要手动干预。

应用冲突达到时升级错误处理（按表）：选中此复选框可在应用冲突数（按表）达到指定数量时升级错误处理。有效值为 1-10,000。

升级操作： 选择升级错误处理时应执行的操作。

* 将记录记录到异常表（默认值）：任务将继续，错误将写入异常表。

* 挂起表：任务将继续，但带有错误记录的表中的数据将移动到错误状态，并且不会复制其数据。

  信息注释

  行为因更改处理模式而异：

  * 在事务性应用模式中，不会复制最后的更改

  * 在批处理优化应用模式中，可能出现没有数据复制或数据复制是部分复制的情况。

* 停止任务：任务已停止，需要手动干预。

#### 环境错误

* 最大重试数选择此选项，然后指定发生可恢复环境错误时重试任务的最大尝试次数。重试任务达到指定次数后，任务将停止，需要手动干预。

  若要从不重试任务，请清除复选框或指定“0”。

  要无限次重试任务，请指定“-1”

  * 重试间隔（秒）使用计数器选择或键入系统在尝试重试任务之间等待的秒数。

    有效值为 0-2000。

* 延长长时间停机的重试间隔选中此复选框可增加长时间停机的重试间隔。启用此选项后，每次重试之间的间隔将加倍，直到达到最大重试间隔（并根据指定的最大间隔继续重试）。

  * 最大重试间隔（秒）使用计数器选择或键入在启用增加长时间中断的重试间隔选项时任务重试之间等待的秒数。有效值为 0-2000。

## 更改处理调谐

### 事务卸载调整

* 如果出现以下情况，则将正在进行的事务卸载到磁盘：

  复制任务通常将事务数据保存在内存中，直到它完全提交到源和/或目标。但是，大于分配内存或未在指定时间限制内提交的事务将被卸载到磁盘。

  * 事务内存大小超过 (MB)：所有事务在卸载到磁盘之前可以在内存中占用的最大大小。默认值为 1024。
  * 事务持续时间超过（秒）：每个事务在卸载到磁盘之前可以在内存中停留的最长时间。持续时间是从复制任务开始捕获事务的时间开始计算的。默认值为 60。

### 批量调节

此选项卡中的设置通过应用更改模式决定。

信息注释在复制到数据仓库目标或使用 Qlik Talend Cloud Starter 订阅工作时，您无法选择要使用的应用更改模式。更改将始终应用于批量优化模式，以获得最大效率。但复制到 Snowflake 目标且加载方法设置为 Snowpipe 数据流时除外。在这种情况下，虽然仍无法选择使用哪种应用更改模式，但更改将始终在事务性模式下应用。

#### 仅在“应用模式”为“批量优化”时可用的设置

* 在间隔中应用分批更改：

  * 大于：每次应用批量更改之间等待的最短时间。默认值为 1。

    增大长于值会降低对目标应用更改的频率，同时增加批次的大小。当将更改应用于为处理大批量而优化的目标数据库时，这可以提高性能。

  * 少于：每次应用批量更改之间等待的最长时间（在声明超时之前）。换句话说，就是可接受的最大延迟。默认值为 30。该值确定在达到长于值之后应用更改之前等待的最长时间。

* 处理内存超过该值时强制应用批次 (MB)：在批处理优化应用模式下用于预处理的最大内存量。默认值为 500。

  对于最大批处理大小，请将此值设置为可以分配至复制任务的最大内存量。当将更改应用于为处理大批量而优化的目标数据库时，这可以提高性能。

#### 仅在“应用模式”为“事务”时可用的设置

以下设置仅适用于在“事务”应用模式下工作时。请注意，复制到 Snowflake 时，“事务”是唯一可用的应用模式（因此不可选择），加载方法是 Snowpipe 数据流。

* 每笔交易的最小更改次数：每个事务中要包含的最小更改数。默认值为 1000。

  信息注释

  当更改次数等于或大于每个事务的最小更改次数值时，或者当达到下面描述的应用前批处理事务的最长时间（秒）值时，将对目标应用更改，以先发生的为准。由于应用于目标的更改频率由这两个参数控制，因此对源记录的更改可能不会立即反映在目标记录中。

* 应用前批处理事务的最长时间（秒）：在声明超时之前分批收集事务的最长时间。默认值为 1。

### 间隔

信息注释这些设置仅适用于 SAP ODP 连接器。

* 每（分钟）读取更改

  从源读取更改的间隔（分钟）。有效范围为 1 到 1440。

  信息注释

  要使用此选项，任务必须采用：

  * 数据移动网关
  * 应用更改或存储更改更新方法

检查是否有更改

* 根据增量提取间隔： 选中此选项后，数据任务会根据增量提取间隔来检查更改。

  信息注释该间隔将在每个“轮次”后开始。一个轮次可以定义为数据任务从源表读取更改并将其发送至目标（作为单个事务）所需的时间。一个轮次的长度会根据表的数量及更改的数量而变化。因此，如果您指定 10 分钟的间隔，并且一个轮次需要 4 分钟，那么检查更改之间的实际时间将为 14 分钟。

  * 增量提取间隔： 从您的系统之中提取增量的频率。默认值为每 60 秒一次。

* 按计划：选中此选项之后，数据任务将提取一次增量，然后停止。然后它将继续按计划运行。

  信息注释仅当 CDC 周期之间的间隔为 24 小时或者更长时，此选项才相关。

  有关计划的信息：

  * 要了解复制项目中的“复制数据任务”，请参阅 [计划任务](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm#Scheduli2)

### 其他调谐

#### 语句缓存大小（语句数）

要存储在服务器上以供以后执行（在对目标应用更改时）的最大准备语句数。默认值为 50。最大值为 200。

#### 更新主键列时执行 DELETE 和 INSERT 操作

此选项仅在启用 存储更改 复制模式时可用，并且要求在源数据库中启用完全补充日志记录。

#### 删除时发送墓碑

信息注释此选项仅在使用 Kafka 目标连接器时可用。

选中此选项时，仅填充消息键；消息本身将为 null，表示该项已被删除。这可以帮助使用者检测到已执行 DELETE 操作。

#### 将任务恢复数据存储在目标数据库中

信息注释当复制到[数据仓库目标](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/data-warehouses-connections.htm)时，此选项不可用。

选择此选项可将特定于任务的恢复信息存储在目标数据库中。选择此选项后，复制任务将在目标数据库中创建一个名为 `attrep_txn_state` 的表。此表包含事务数据，这些数据可用于在 数据移动网关Data 文件夹中的文件损坏或包含 Data 文件夹的存储设备出现故障时恢复任务。

#### 使用 SQL MERGE 应用更改

信息注释此选项仅在复制到某些[数据仓库目标](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/data-warehouses-connections.htm)时可用（有关详细信息，请参阅下文）。

如果未选择此选项，则复制任务将为净变化表中的每个不同更改类型执行单独的批量 INSERT、UPDATE 和 DELETE 语句。

提示注释在批处理优化应用模式下工作时，会在目标上创建“净变化”表，其中包含在源上更改的记录。每次将源更改应用于目标时，它都会被截断。

虽然此方法效率很高，但在使用支持此选项的端点时，启用使用 SQL MERGE 应用更改选项的效率甚至更高。

原因如下：

* 它将每个表运行的 SQL 语句数从三个减少到一个。在大型、不可变、基于文件的云数据库（如 Google Cloud BigQuery）中，大多数 UPDATE 操作都涉及重写受影响的文件。对于此类操作，每个表的 SQL 语句从三个减少到一个效果非常显著。
* 目标数据库只需扫描“净变化”表一次，即可显著减少 I/O。

优化插入

如果将使用 SQL MERGE 应用更改与优化插入选项一起选中，并且更改仅由 INSERT 组成，则复制任务将执行 INSERT，而不是使用 SQL MERGE。注意，虽然这通常会提高性能，从而降低成本，但也可能导致目标数据库中出现重复记录。

信息注释

* 使用 SQL MERGE 应用更改和优化插入选项仅适用于配置有以下目标端点的任务：

  * Google Cloud BigQuery
  * Databricks
  * Snowflake

* 使用 SQL MERGE 应用更改和优化插入选项不支持以下源端点：

  * Salesforce
  * oracle

* 启用了使用S QL MERGE 应用更改选项时：

  * 非致命数据错误或无法恢复的数据错误将作为表错误处理。
  * 对于以下设置，[应用冲突错误处理策略](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm#Apply2)将不可以编辑。
    * 找不到应用 DELETE 的记录：忽略记录

    * 应用 INSERT 时出现重复键：UPDATE 现有目标记录

      信息注释如果还选择了优化插入选项，则应用 INSERT 时出现复制键选项将设置为允许在目标中重复。

    * 找不到应用 UPDATE 的记录： INSERT（插入）缺少的目标记录

    * 升级操作：将记录写入异常表
  * 以下针对其他数据错误[数据错误处理策略](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/replicating-settings.htm#Data)选项将不可用：
    * 忽略记录
    * 将记录记录到异常表
  * 实际的 SQL MERGE 操作将仅在最终目标表上执行。INSERT 操作将在中间更改表上执行（当启用了应用更改或存储更改复制模式时）。

### 事务性应用

信息注释

当复制到数据仓库目标时，或在不使用 数据移动网关 工作时，这些选项并不相关，因为应用模式始终是批量优化的，但存在一个例外。

但复制到 Snowflake 且加载方法设置为 Snowpipe 数据流时除外。

以下设置仅在事务性应用模式下工作时可用。复制到数据库时，可将应用模式设置为批处理优化模式或事务性模式。但是，当复制到 Snowflake 目标且加载方法设置为 Snowpipe 数据流时，应用模式始终为事务性，因此无法设置。

* 每笔交易的最小更改次数：每个事务中要包含的最小更改数。默认值为 1000。

  信息注释当更改次数等于或大于每个事务的最小更改次数值时，或当达到批处理超时值时（见下文）， 复制任务将更改应用于目标（以先发生的为准）。由于应用于目标的更改频率由这两个参数控制，因此对源记录的更改可能不会立即反映在目标记录中。

* 应用前批处理事务的最长时间（秒）：在声明超时之前分批收集事务的最长时间。默认值为 1。

## 自动模式演进

信息注释使用 SaaS 应用程序连接器时，仅支持更改列数据类型。

选择如何处理架构中以下类型的 DDL 更改。更改模式演变设置后，必须重新准备任务。选择如何处理架构中以下类型的 DDL 更改。

| DDL 更改 | 应用于目标 | 忽略 | 挂起表 | 停止任务 |
| --- | --- | --- | --- | --- |
| 添加列 | 支持 | 支持 | 支持 | 支持 |
| 更改列数据类型 | 支持 | 支持 | 支持 | 支持 |
| 重命名列 | 支持 | 不支持 | 支持 | 支持 |
| 重命名表格<br><br>信息注释当 Kafka 是目标平台时不受支持。 | 不支持 | 不支持 | 支持 | 支持 |
| 放置列 | 支持 | 支持 | 支持 | 支持 |
| 删除表<br><br>信息注释当 Kafka 是目标平台时不受支持。 | 支持 | 支持 | 支持 | 支持 |
| 创建表格<br><br>如果使用选择规则添加与模式匹配的数据集，则将检测并添加符合模式的新表。 | 支持 | 支持 | 不支持 | 不支持 |

## 字符替换

您可以替换或删除目标数据库中的源字符，和/或替换或删除所选字符集不支持的源字符。

信息注释

* 所有字符都必须指定为 Unicode 代码点。

* 字符替换也将在控制表上执行。

* 无效值将由表格单元格右上角的红色三角形指示。将鼠标光标悬停在三角形上会显示错误消息。

* 为任务定义的任何表级或全局转换都将在字符替换完成后执行。

* 在替换或删除源字符表中定义的替换操作在替换或删除所选字符集不支持的源字符表格中定义的替代操作之前执行。

* 字符替换不支持 LOB 数据类型。

### 替换或删除源字符

使用替换或删除源字符表可以定义特定源字符的替换项。例如，当字符的 Unicode 表示在源平台和目标平台上不同时，这可能很有用。例如，在 Linux上，`Shift_JIS` 字符集中的减号字符表示为 `U+2212`，但在 Windows 上，它表示为 `U+FF0D`。

替换操作

| 要 | 进行该操作 |
| --- | --- |
| 定义替代操作 | <ol> <li> <p>单击表上方的<span>添加字符</span>按钮。</p> </li> <li> <p>在<span>源角色</span>和<span>替换角色</span>字段中分别指定源角色和目标角色。</p> <p>例如，要将字母“a”替换为字母“e”，请分别指定 <code>0061</code> 和 <code>0065 </code>。</p> <div><span>信息注释</span> <p>要删除指定的源字符，请在<span>替换字符</span>列中输入 <code>0</code>。</p> </div> </li> <li>重复步骤 1-2 以替换或删除其他字符。</li> </ol> |
| 编辑指定的源或目标角色 | 单击行末尾的 the 编辑 icon 并选择。 |
| 从表中删除条目 | 单击行末尾的 the 删除 icon 并选择。 |

### 替换或删除所选字符集不支持的源字符

使用不支持的源字符（按字符集）表为所选字符集不支持的所有字符定义一个替换字符。

不支持的字符替换操作

| 要 | 进行该操作 |
| --- | --- |
| 定义或编辑替换操作。 | <ol> <li> <p>从表中的<span>字符集</span>下拉列表中选择一个字符集。</p> <p>所选字符集不支持的任何字符将在目标上替换为下面步骤 2 中指定的字符。</p> </li> <li> <p>在<span>替换字符</span>列中，单击列中的任意位置，然后指定替换字符。例如，要将所有不支持的字符替换为字母“a”，请输入<code>0061</code>。</p> <div><span>信息注释</span> <p>要删除所有不支持的字符，请输入<code>0</code>。</p> </div> </li> </ol> |
| 禁用替换操作。 | 从字符集下拉列表中选择空白条目。 |

## 更多选项

这些选项不会在 UI 中公开，因为它们仅与特定版本或环境相关。因此，除非 Qlik 支持或产品文档明确指示，否则不要设置这些选项。

要设置选项，只需将该选项复制到添加功能名称字段中，然后单击添加。然后根据收到的说明设置该值或启用该选项。

## 并行加载数据集片段

信息注释此设置不适用于 SaaS 应用程序源，仅适用于源数据库和目标数据库的特定子集。

在满负载期间，您可以通过将数据集拆分为并行加载的段来加速大型数据集的加载。表可以按数据范围、所有分区、所有子分区或特定分区进行拆分。

有关更多信息，请参阅[并行复制数据集片段](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Replicating/Table-settings-replication.htm)。

## 计划任务

在某些情况下，您可能需要计划任务，以将更改从数据源传播到目标平台。

有关更多信息，请参阅[Scheduling tasks](https://help.qlik.com/zh-CN/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Deploying/Scheduling-tasks.htm)。