# Создание киоска файловой базы знаний
Киоски файловых баз знаний позволяют встраивать неструктурированные данные в базы данных векторов и хранить их там. Это позволяет извлекать дополненный контекст с помощью функциональностей семантического поиска и использовать его в качестве контекста для приложений с генерацией, дополненной поиском (RAG).
Поддерживаются следующие форматы ввода: `PDF`, `TXT` и `DOCX` Word.
## Требования
* Вам нужна подписка Qlik Talend Cloud Enterprise.
* Поддерживается на платформах Snowflake и Databricks. Snowflake Iceberg не поддерживается.
* Требуется управляемый клиентом шлюз данных.
Для Databricks требуется Шлюз данных Qlik — движение данных версия 2024.11.95 или выше.
## Установка Шлюз данных Qlik — движение данных
Прежде чем создавать киоски файловых баз знаний, необходимо установить специальный Шлюз данных Qlik — движение данных. Для получения дополнительной информации см. раздел [Настройка Шлюз данных Qlik — движение данных для киосков баз знаний](https://help.qlik.com/ru-RU/cloud-services/Subsystems/Hub/Content/Sense_Hub/Gateways/gateways-for-knowledge-mart.htm).
## Поддерживаемые подключения
Источники информации о поддерживаемых подключениях см. ниже.
* Базы данных векторов — см. раздел [Подключение к базам данных векторов](https://help.qlik.com/ru-RU/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Landing/connecting-vector-databases.htm).
* Подключения БЯМ — см. раздел [Подключение к подключениям LLM](https://help.qlik.com/ru-RU/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Landing/connecting-llm-connections.htm).
* Хранилище файлов — см. раздел [Подключение к файловому хранилищу](https://help.qlik.com/ru-RU/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Landing/connecting-file-storage.htm).
* Облачное хранилище (Amazon S3, Google Cloud Storage, Azure Data Lake Storage), см. [Подключение к облачному хранилищу](https://help.qlik.com/ru-RU/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/cloud-storage-connections.htm).
## Создание файлов
1. Нажмите Проекты конвейера в левом меню и откройте проект.
2. На странице Проект конвейера можно создать киоск файловой базы знаний. Выполните одно из следующих действий.
* Нажмите Создать > Киоск файловой базы знаний.
* Нажмите the Значок «Действия» icon задачи данных > Киоск файловой базы знаний.
Откроется окно настройки конфигурации.
3. Введите имя.
4. Введите описание. Это необязательно.
5. Создайте или выберите Подключение к источнику.
6. Выберите место хранения документов в раскрывающемся списке Хранить векторы в. Чтобы хранить документы вместе с проектом, выберите Платформа проектов данных.
7. Если выбран параметр Внешняя база данных векторов, создайте или выберите Подключение к базе данных векторов. Документы и векторы будут храниться в этой базе данных векторов.
8. Создайте или выберите Подключение БЯМ. Это подключение необходимо для использования семантического поиска.
9. Нажмите Создать.
10. После создания киоска базы знаний добавьте документы.
## Добавление файлов
Примечание к информацииВ документы записывается только текст. Текст из диаграмм или изображений не извлекается.
1. Выберите папку на вкладке Папки страницы Задача данных или нажмите Выберите папки, чтобы выбрать новую папку.
2. Перейдите к папке и установите флажок рядом с папкой.
Все файлы в папках будут прочитаны, если они имеют один из поддерживаемых форматов, независимо от того, когда они были добавлены в папку.
При удалении из папки файла, который уже существует в индексе, его данные остаются в индексе. Чтобы удалить данные из индекса, используйте тот же файл, но пустой.
Чтобы отобразить список файлов в папке, нажмите ее правой кнопкой мыши.
3. Нажмите Сохранить, чтобы закрыть окно Выберите папки.
4. Чтобы изменить размер блока и перекрытие блоков, нажмите Параметры > Время выполнения.
5. Чтобы изменить название индекса, нажмите Параметры > Настройки базы данных векторов.
Для получения дополнительной информации см. раздел [Имя индекса](https://help.qlik.com/ru-RU/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/KnowledgeMart/Creating-file-based-knowledge-mart.htm#Index).
6. Нажмите the Значок «Действия» icon справа > Подготовить.
7. По завершении подготовки нажмите Запустить. Документы будут встраиваться и передаваться.
Передача выполняется, когда кнопка Запустить активна.
8. При первой полной загрузке проверьте состояние каждого файла:
1. Выберите в меню Мониторинг.
2. Выберите в нижней части страницы Состояние полной загрузки.
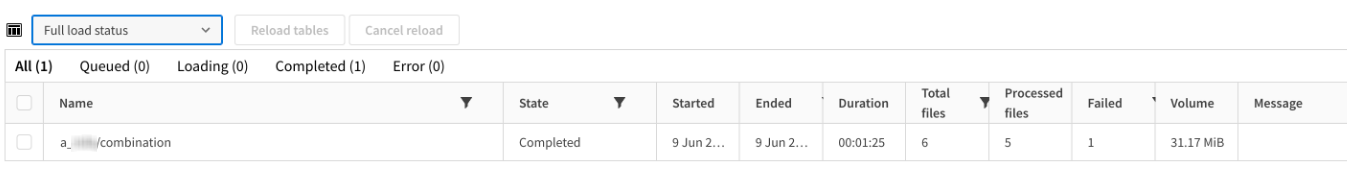
3. Если с некоторыми файлами произошел сбой, исправьте ошибки или удалите файлы, прежде чем запускать все заново. Если сохранить файлы с ошибками, следующие запуски будут неудачными.
Примечание к информацииПерезагрузка всех файлов может привести к дополнительным расходам.
Когда файлы будут в порядке, можно будет задавать вопросы о данных. Для получения дополнительной информации см. раздел [Использование помощника по проведению тестов](https://help.qlik.com/ru-RU/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/KnowledgeMart/Test-Assistant.htm).
## Полная загрузка и захват изменений данных (CDC)
Поддерживаются полная загрузка и CDC.
Полная загрузка. Для каждого экземпляра документа создается документ, который отправляется в цель.
CDC. Документ создается заново после любого изменения.
При изменении или добавлении файла документы считываются из этого файла. Файл разбивается на документы, состоящие из блоков, в соответствии с размером блока и перекрытием.
При первой полной загрузке проверьте состояние каждого файла:
1. Выберите в меню Мониторинг.
2. Выберите в нижней части страницы Состояние полной загрузки.

3. Если с некоторыми файлами произошел сбой, исправьте ошибки или удалите файлы, прежде чем запускать все заново. Если сохранить файлы с ошибками, следующие запуски будут неудачными.
Примечание к информацииПерезагрузка всех файлов может привести к дополнительным расходам.
## Обновление ввода данных
При обновлении ввода данных необходимо запустить задачу данных, чтобы передать изменения в базу данных векторов или на платформу данных.
Поскольку старые блоки удаляются, а новые вставляются, поле `hdr__operation` соответствует операции вставки, а не операции обновления. Для получения дополнительной информации см. раздел [Архитектура базы данных в облачном хранилище данных](https://help.qlik.com/ru-RU/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Storage/dataset-tables.htm).
## Имя индекса
Каждый киоск базы знаний имеет имя индекса, которое используется для семантического поиска.
При настройке задач для записи в один и тот же индекс необходимо настроить одинаковые параметры БЯМ для этих задач.
Если вы хотите, чтобы ваши документы находились в одном индексе, они должны иметь одинаковое имя индекса.
Чтобы изменить имя индекса:
1. На странице задачи данных нажмите Настройки.
2. Выберите вкладку Настройки векторной базы данных.
3. Измените Имя индекса.
4. Нажмите кнопку ОК.
После изменения имя индекса необходимо подготовить задачу. В противном случае изменения не будут применяться в следующих запусках.
## Просмотр информации о задаче
Нажмите the Сведения icon на панели меню, чтобы просмотреть информацию о задаче, например:
* Владелец
* Пространство
* Платформа данных
* Идентификатор проекта
* Идентификатор выполнения задачи данных
## Настройки
Можно просматривать и изменять параметры киоска базы знаний.
На странице Задача данных нажмите the More Horizontal icon > Параметры.
Примечание к информацииПоскольку параметры зависят от хранилища (Databricks, Snowflake и т. п.), в следующих таблицах описаны параметры, которые всегда доступны. Могут быть доступны и другие параметры.
В этой таблице описаны параметры вкладки ПодключенияПодключения.
| Настройки | Описание |
| --- | --- |
| Подключение к источнику | Подключение к источнику. |
| Хранить векторы в | В раскрывающемся списке выберите:
- Внешняя база данных векторов
- Платформа проектов данных
|
| Подключение к базе данных векторов
Этот параметр доступен, если для параметра Хранить векторы в выбрано значение Внешняя база данных векторов. | Подключение к базе данных векторов.
Для получения дополнительной информации см. раздел [Подключение к базам данных векторов](https://help.qlik.com/ru-RU/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Landing/connecting-vector-databases.htm). |
| Подключение БЯМ | Подключение БЯМ.
Для получения дополнительной информации см. раздел [Подключение к подключениям LLM](https://help.qlik.com/ru-RU/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Landing/connecting-llm-connections.htm).
Если в качестве подключения БЯМ необходимо использовать Databricks, настройте конечную точку обслуживания модели встраивания и конечную точку обслуживания модели завершения при создании киоска базы знаний. Для получения дополнительной информации см. [документацию по Databricks](https://docs.databricks.com/aws/en/machine-learning/model-serving/create-foundation-model-endpoints#create-an-external-model-serving-endpoint). |
В этой таблице описаны параметры вкладки Параметры платформыПараметры платформы.
| Настройки | Описание |
| --- | --- |
| Схема задачи данных | Имя схемы задачи данных. |
| Внутренняя схема | Имя внутренней схемы. |
| Префикс для всех таблиц и видов | Префикс для разрешения конфликтов между несколькими задачами данных. |
В этой таблице описаны параметры вкладки Настройки базы данных векторовНастройки базы данных векторов.
| Настройки | Описание |
| --- | --- |
| Схема индекса
Этот параметр недоступен, если для параметра Хранить векторы в выбрано значение Внешняя база данных векторов. | Имя схемы индекса. |
| Имя индекса | Имя индекса. |
| Если индекс уже существует | Если несколько задач записывают данные в один и тот же индекс, выберите, нужно ли удалять индекс:
- Использовать существующий индекс: индекс не удаляется.
- Отбросить и создать индекс. Индекс удаляется.
|
| Конечная точка поиска векторов Databricks | Имя конечной точки векторного поиска, созданной в Databricks. Для получения дополнительной информации см. раздел [Настройка Databricks для витрин знаний](https://help.qlik.com/ru-RU/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/KnowledgeMart/Creating-knowledge-marts.htm#Configur).
Примечание к информацииПрименимо только к проектам, использующим Databricks в качестве платформы данных. |
В этой таблице описаны параметры вкладки Время выполненияВремя выполнения.
| Настройки | Описание |
| --- | --- |
| Параллельное выполнение | Максимальное количество подключений к базе данных.
Введите значение от 1 до 50. |
| Массовый размер | Для киосков баз знаний массовый размер — это количество документов, загружаемых в каждом массовом запросе.
Для киосков файловых баз знаний массовый размер — это количество файлов, загружаемых в каждом массовом запросе.
В Snowflake и Databricks массовый размер не требуется, поскольку все загружается в одном запросе. |
| Максимальное количество записей для загрузки | «0» означает, что все записи загружены. |
В этой таблице описаны параметры вкладки ВидыВиды для Snowflake.
| Настройки | Описание |
| --- | --- |
| Стандартные виды | Используйте стандартные виды для отображения результатов запроса в формате таблицы. |
| Защищенные виды Snowflake | Используйте защищенные виды Snowflake для представления конфиденциальных данных или защищенной информации. В частности, такие виды могут создаваться, если требуется ограничить доступ к конфиденциальным данным и данные не должны быть видны пользователям, имеющим доступ к базовым таблицам.
Защищенные виды Snowflake могут выполняться медленнее, чем стандартные представления. |
В этой таблице описаны параметры вкладки Помощник по тестированиюПомощник по тестированию.
| Параметры | Описание |
| --- | --- |
| Количество документов в контексте | Количество релевантных документов, которые будут переданы в модель в качестве контекста. |
| Шаблон запроса | Введите шаблон, которому ИИ должен следовать для фильтрации включаемых документов. |
| Фильтр | Введите выражение для фильтрации включаемых документов.
Поскольку фильтр основан на метаданных, а файловые хранилища знаний не имеют метаданных, тщательно продумайте настраиваемый фильтр. Возможно, более целесообразно исключать данные, а не включать их.
Для получения дополнительной информации см. раздел [Использование помощника по проведению тестов](https://help.qlik.com/ru-RU/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/KnowledgeMart/Test-Assistant.htm). |
| Получение документов | Выберите параметр в раскрывающемся списке:
- Показать извлеченный контекст: Помощник по тестированию предоставляет документы, на основе которых он генерирует ответ.
- Не показывать извлеченный контекст: Помощник по тестированию генерирует ответ, но не предоставляет документы.
|
| Создание ответов | Выберите параметр в раскрывающемся списке:
- Генерировать ответы: Помощник по тестированию генерирует ответ на основе документов.
- Не генерировать ответы: Тестовый помощник отвечает только с помощью документов.
|
## Изменение подключений или шлюза данных
В случае изменения подключения источника, вектора или шлюза векторных данных, задачу нужно подготовить сначала.