# Top - 차트 함수
Top()은 테이블의 열 세그먼트 내에 있는 첫 번째(맨 위) 행의 표현식을 평가합니다. 계산되는 행은 offset(있는 경우) 값에 따라 달라지며 기본적으로는 맨 위에 있는 행입니다. 테이블 이외의 차트인 경우 Top()은 해당 차트의 일반표 동등 부분에 있는 현재 열의 첫 번째 행을 평가합니다.
구문:
Top([TOTAL] expr [ , offset [,count ]])
반환 데이터 유형: 이중
인수
| 인수 | 설명 |
| --- | --- |
| expr | 측정할 데이터가 포함된 표현식 또는 필드입니다. |
| offset | offset을 n로 지정하면 1보다 큰 값으로 표현식 평가가 맨 위 행 아래 n행으로 이동합니다.
오프셋을 음수로 지정하면 Top 함수가 상응하는 양수 오프셋이 있는 Bottom 함수와 동일하게 작동합니다. |
| count | 세 번째 파라메타 count를 1보다 크게 지정하면 이 함수에서 count의 범위 값을 반환하며, 현재 열 세그먼트의 마지막 count 행 각각에 대해 하나의 값을 반환합니다. 이러한 형식으로 이 함수를 특별 범위 함수의 인수로 활용할 수 있습니다. [범위 함수](https://help.qlik.com/ko-KR/cloud-services/Subsystems/Hub/Content/Sense_Hub/ChartFunctions/RangeFunctions/RangeFunctionsInCharts.htm) |
| TOTAL | 테이블이 1차원이거나 TOTAL 한정자를 인수로 사용하는 경우 현재 열 세그먼트는 항상 전체 열과 동등합니다.
[집계 범위 정의](https://help.qlik.com/ko-KR/cloud-services/Subsystems/Hub/Content/Sense_Hub/ChartFunctions/define-aggregation-scope.htm) |
정보 메모열 세그먼트는 현재 정렬 순서에서 차원에 대해 동일한 값을 갖는 셀의 연속된 하위 집합으로 정의됩니다. 인터 레코드 차트 함수는 동등한 일반표 차트의 가장 오른쪽 차원을 제외한 열 세그먼트에서 계산됩니다. 차트에 차원이 하나만 있는 경우 또는 TOTAL 한정자가 지정된 경우는 표현식이 전체 테이블을 평가합니다.
정보 메모테이블 또는 테이블과 동등한 것에 여러 세로 차원이 있을 경우 현재 열 세그먼트에는 필드 간 정렬 순서에서 마지막 차원이 표시되는 열을 제외하고 모든 차원 열 내의 현재 행과 같은 값을 가진 행만 포함됩니다.
제한 사항:
* 재귀 호출은 NULL을 반환합니다.
* 이 차트 함수가 차트의 표현식에서 사용되는 경우 차트의 y 값에 대한 정렬 또는 테이블의 표현식 열에 의한 정렬은 허용되지 않습니다. 따라서 해당 정렬 옵션이 자동으로 비활성화됩니다. 시각화 또는 테이블에서 이 차트 함수를 사용하면 시각화의 정렬이 이 함수에 대해 정렬된 입력으로 되돌아갑니다.
예: 차트 표현식
| 예제 | 결과 |
| --- | --- |
| `Top( Sum(Sales) )` | 표의 열 세그먼트의 첫 번째(맨 위) 행에 대한 `Sales` 값을 반환합니다. |
## 예 - Top 기본 사항
[](https://help.qlik.com/en-US/cloud-services/Subsystems/Hub/Content/Sense_Hub/ChartFunctions/InterRecordFunctions/top.htm)
#### 차트 표현식
개요
데이터 로드 편집기를 열고 새 섹션에 아래 로드 스크립트를 추가합니다.
로드 스크립트에는 다음이 포함됩니다.
* `Example`이라는 데이터 테이블에 로드되는 데이터 집합입니다.
* 데이터 테이블의 필드는 다음과 같습니다.
* `Year`
* `Sales`
로드 스크립트
```
Example:
LOAD * INLINE [
Year, Sales
2019, 1000
2020, 1500
2021, 1200
2022, 1800
2023, 1700
];
```
결과
데이터를 로드하고 시트를 엽니다. 새 테이블을 만들고 이 필드를 차원으로 추가합니다.
* `Year`
다음 측정값을 만듭니다.
* `=Sum(Sales)`: 연간 판매량을 찾습니다.
* `=Top(Sum(Sales))`: 첫해의 판매량 값을 찾으려면 테이블의 열의 첫 번째(맨 위) 행을 찾습니다.
* `=Sum(Sales) - Top(Sum(Sales))`: 현재 행의 `Sales` 값과 열의 첫 번째(맨 위) 행 값 간의 변동을 계산합니다.
* `=Sum(Sales)-Top(Sum(Sales), 3)`: 현재 행의 판매량 값과 위에서 3번째 행 값 간의 변동을 계산합니다.
* `=(Sales - Top(Sales)) / Top(Sales)`: 첫 번째 행과 비교한 비율/백분율로 `Sales`의 변경 내용을 반환합니다. 이 값을 백분율로 표시하려면 숫자 서식에서 숫자 > 서식 단순 > 12.34%를 선택합니다.
차원 `Year`에 대한 테이블을 오름차순으로 정렬합니다.
결과 테이블
| Year | Sum(Sales) | Top(Sum(Sales)) | Sum(Sales) - Top(Sum(Sales)) | Sum(Sales)-Top(Sum(Sales), 3) | (Sales - Top(Sales)) / Top(Sales) |
| --- | --- | --- | --- | --- | --- |
| Totals | 7200 | 1000 | 6200 | 6000 | - |
| 2019 | 1000 | 1000 | 0 | -200 | 0.00% |
| 2020 | 1500 | 1000 | 500 | 300 | 50.00% |
| 2021 | 1200 | 1000 | 200 | 0 | 20.00% |
| 2022 | 1800 | 1000 | 800 | 600 | 80.00% |
| 2023 | 1700 | 1000 | 700 | 500 | 70.00% |
결과를 살펴보면 현재 기간의 `Sales` 값을 상위(또는 첫 번째) 기간과 비교할 수 있습니다.
* `Sum(Sales) - Top(Sum(Sales))` 측정값은 현재 기간을 첫 번째 기간과 비교하여 `Sales` 값의 변경 내용을 반환합니다.
* `Sum(Sales)-Top(Sum(Sales), 3)` 측정값은 위에서 세 번째 기간을 뺀 현재 행의 `Sales` 합계를 반환합니다.
* `=(Sales - Top(Sales)) / Top(Sales)` 측정값은 첫 번째 기간과 비교한 `Sales`의 변경 내용을 백분율로 반환합니다.
팁 메모이 기능은 테이블 이외의 차트(예: 막대형 차트)에서 사용할 수 있습니다.
다음과 같이 하십시오.
막대형 차트를 만든 다음 이 필드를 차원으로 추가합니다.
* `Year`
다음 측정값을 만듭니다.
* `=Sum(Sales)- Top(Sum(Sales))`: 현재 기간과 상위 기간 사이의 판매량 변동을 반환합니다.
Top 함수에 대한 결과를 보여 주는 막대형 차트
Top 함수에 대한 결과를 보여 주는 막대형 차트
TopTop 함수에 대한 결과를 보여 주는 막대형 차트 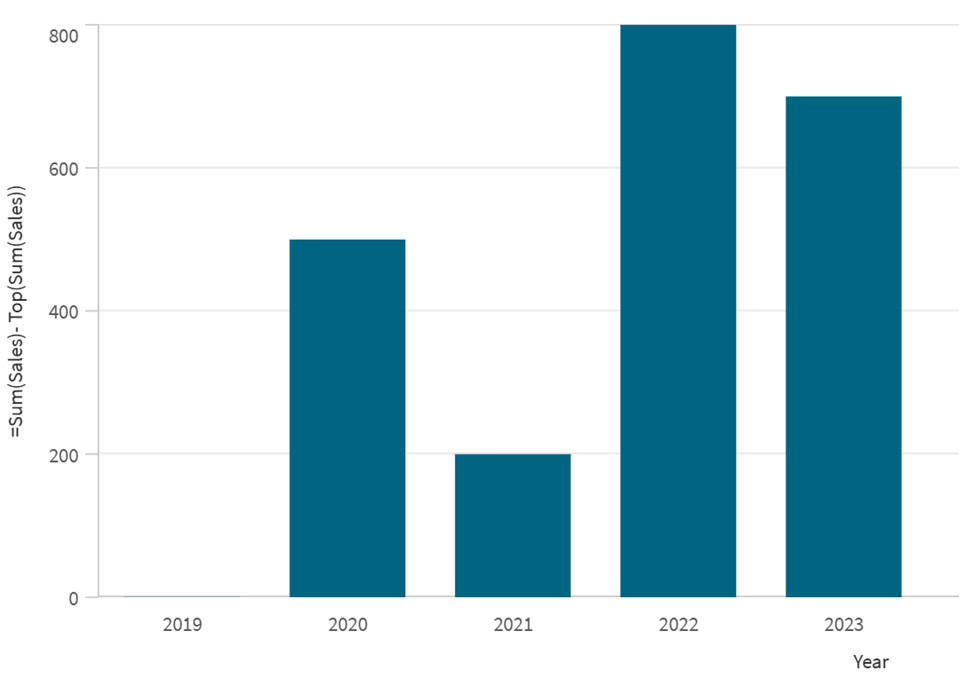
막대형 차트에서 `Top` 함수를 사용하면 현재 기간의 판매량과 상위(또는 첫 번째) 기간의 판매량 간의 변동을 시각적으로 비교할 수 있습니다.
## 예 - Top 시나리오
[](https://help.qlik.com/en-US/cloud-services/Subsystems/Hub/Content/Sense_Hub/ChartFunctions/InterRecordFunctions/top.htm)
#### 차트 표현식
개요
데이터 로드 편집기를 열고 새 섹션에 아래 로드 스크립트를 추가합니다.
로드 스크립트에는 다음이 포함됩니다.
* `Example`이라는 데이터 테이블에 로드되는 데이터 집합입니다.
* 데이터 테이블의 필드는 다음과 같습니다.
* `OrderID`
* `Product`
* `SalesValue`
* `OrderDate`
로드 스크립트
```
Example:
LOAD * INLINE [
OrderID, Product, SalesValue, OrderDate
1, "Product A", 500, '2023-01-10'
2, "Product B", 300, '2023-01-15'
3, "Product C", 450, '2023-02-01'
4, "Product D", 700, '2023-02-20'
5, "Product E", 350, '2023-03-05'
];
```
결과
데이터를 로드하고 시트를 엽니다. 새 테이블을 만들고 이 필드를 차원으로 추가합니다.
* `Product`
다음 측정값을 만듭니다.
* `=RangeAvg(Top(Sum(SalesValue),1,3))`은 상위 3개 행의 평균을 반환합니다.
* `=Sum(SalesValue) - RangeAvg (Top(Sum(SalesValue),1,3))`: 현재 행과 상위 3개 행의 평균 간의 변동을 계산합니다.
* `=Sum(SalesValue)`: 현재 행의 총 `SalesValue`을 계산합니다.
결과 테이블
| Product | RangeAvg(Top(Sum(SalesValue),1,3)) | Sum(SalesValue) - RangeAvg (Top(Sum(SalesValue),1,3)) | Sum(SalesValue) |
| --- | --- | --- | --- |
| Totals | 416.67 | 1883.33 | 2300 |
| 2019 | 416.67 | 83.33 | 500 |
| 2020 | 416.67 | --116.67 | 300 |
| 2021 | 416.67 | 33.33 | 450 |
| 2022 | 416.67 | 283.33 | 700 |
| 2023 | 416.67 | -66.67 | 350 |
결과는 `RangeSum` 함수와 `Top` 함수를 조합하여 판매량 값을 분석하고 비교하는 방법을 보여 줍니다.
## 예 - Top를 사용한 차트 표현식
[](https://help.qlik.com/en-US/cloud-services/Subsystems/Hub/Content/Sense_Hub/ChartFunctions/InterRecordFunctions/top.htm)
#### 차트 표현식
개요
데이터 로드 편집기를 열고 새 섹션에 아래 로드 스크립트를 추가합니다.
로드 스크립트에는 다음이 포함됩니다.
* `Monthnames` 및 `Sales2013`이라는 두 개의 데이터 테이블.
로드 스크립트
```
Monthnames:
LOAD *, Dual(MonthText,MonthNumber) as Month INLINE [
MonthText, MonthNumber
Jan, 1
Feb, 2
Mar, 3
Apr, 4
May, 5
Jun, 6
Jul, 7
Aug, 8
Sep, 9
Oct, 10
Nov, 11
Dec, 12
];
Sales2013:
Crosstable (MonthText, Sales) LOAD * inline [
Customer|Jan|Feb|Mar|Apr|May|Jun|Jul|Aug|Sep|Oct|Nov|Dec
Astrida|46|60|70|13|78|20|45|65|78|12|78|22
Betacab|65|56|22|79|12|56|45|24|32|78|55|15
Canutility|77|68|34|91|24|68|57|36|44|90|67|27
Divadip|57|36|44|90|67|27|57|68|47|90|80|94
] (delimiter is '|');
```
결과
데이터를 로드하고 시트를 엽니다. 새 테이블을 만들고 이 필드를 차원으로 추가합니다.
* `Customer`
다음 측정값을 만듭니다.
* `=Sum(Sales)`: 판매량 합계를 계산합니다.
* `=Top(Sum(Sales))`: 상단 행에 `Customer`의 판매량 합계를 표시합니다.
* `=Sum(Sales)+Top(Sum(Sales))`: 현재 `Customer`의 `Sum(Sales)` 값을 상단 행의 `Customer`에 추가합니다.
* `=Sum(Sales)+Top(Sum(Sales), 3)`: 현재 `Customer`의 `Sum(Sales)` 값을 맨 위 행에서 세 번째인 `Customer` 값과 추가합니다.
결과 테이블
| Customer | Sum(Sales) | Top(Sum(Sales)) | Sum(Sales)+Top(Sum(Sales)) | Sum(Sales)+Top(Sum(Sales), 3) |
| --- | --- | --- | --- | --- |
| Totals | 2566 | 587 | 3153 | 3249 |
| Astrida | 587 | 587 | 1174 | 1270 |
| Betacab | 539 | 587 | 1126 | 1222 |
| Canutilty | 683 | 587 | 1270 | 1366 |
| Divadip | 757 | 587 | 1344 | 1440 |
측정값 `Top(Sum(Sales))`는 모든 행에 대해 `587`을 반환합니다. 이는 최상위 행의 값인 `Astrida`이기 때문입니다.
측정값 `Sum(Sales)+Top(Sum(Sales))`의 경우 행 `Betacab`은 `1126`을 반환합니다. 이는 `Betacab`의 `Sum(Sales)` 값과 맨 위 행의 `Customer`인 `Astrida`를 더한 결과입니다.
측정값 `Sum(Sales)+Top(Sum(Sales), 3)`의 경우 인수 `offset`은 `3`으로 설정됩니다. 표현식은 현재 행과 위에서 세 번째 행인 `Canutility`에 대해 `Sum(Sales)` 값을 추가합니다. 예를 들어, 고객 `Divadip`에 대해 값 `1440`이 반환됩니다. 이는 `Divadip`에 대한 `Sum(Sales)` 값과 `Canutility`에 대한 `SumSales` 값을 더한 결과입니다(`757`+`683`).
## 자세한 정보
* [Bottom - 차트 함수](https://help.qlik.com/ko-KR/cloud-services/Subsystems/Hub/Content/Sense_Hub/ChartFunctions/InterRecordFunctions/bottom.htm)
* [Above - 차트 함수](https://help.qlik.com/ko-KR/cloud-services/Subsystems/Hub/Content/Sense_Hub/ChartFunctions/InterRecordFunctions/above.htm)
* [Sum - 차트 함수](https://help.qlik.com/ko-KR/cloud-services/Subsystems/Hub/Content/Sense_Hub/ChartFunctions/BasicAggregationFunctions/sum.htm)
* [RangeAvg 스크립트 및 차트 함수](https://help.qlik.com/ko-KR/cloud-services/Subsystems/Hub/Content/Sense_Hub/ChartFunctions/RangeFunctions/rangeavg.htm)
* [범위 함수](https://help.qlik.com/ko-KR/cloud-services/Subsystems/Hub/Content/Sense_Hub/ChartFunctions/RangeFunctions/RangeFunctionsInCharts.htm)