# ファイルベースのナレッジ マートの作成
ファイルベースのナレッジマートを使用すると、非構造化データをベクター データベースに埋め込んで保存できます。この操作により、拡張コンテキストをセマンティック検索機能で取得し、検索拡張生成 (RAG) アプリケーションのコンテキストとして使用できるようになります。
サポートされている入力形式は、`PDF`、`TXT`、Word `DOCX` です。
## 要件
* Qlik Talend Cloud Enterprise サブスクリプションが必要です。
* Snowflake および Databricks プラットフォームでサポートされています。Snowflake Iceberg には対応していません。
* 顧客が管理するデータ ゲートウェイが必要です。
Databricks には、Qlik データ ゲートウェイ - データ移動 バージョン 2024.11.95 以降が必要です。
## Qlik データ ゲートウェイ - データ移動 のインストール
ファイルベースのナレッジ マートを作成する前に、特定の Qlik データ ゲートウェイ - データ移動 をインストールする必要があります。詳細については、「[ナレッジマート用の Qlik データ ゲートウェイ - データ移動 の設定](https://help.qlik.com/ja-JP/cloud-services/Subsystems/Hub/Content/Sense_Hub/Gateways/gateways-for-knowledge-mart.htm)」を参照してください。
## サポートされている接続
サポートされる内容については、次を参照してください。
* ベクター データベースについては、「[ベクター データベースへの接続](https://help.qlik.com/ja-JP/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Landing/connecting-vector-databases.htm)」を参照してください。
* LLM 接続については、「[LLM 接続への接続](https://help.qlik.com/ja-JP/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Landing/connecting-llm-connections.htm)」を参照してください。
* ファイル ストレージについては、「[ファイル ストレージへの接続](https://help.qlik.com/ja-JP/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Landing/connecting-file-storage.htm)」を参照してください。
* クラウド ストレージ (Amazon S3、Google Cloud Storage、Azure Data Lake Storage) については、「[クラウド ストレージへの接続](https://help.qlik.com/ja-JP/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/cloud-storage-connections.htm)」を参照してください。
## ファイルの作成
1. 左メニューの [パイプライン プロジェクト] をクリックし、プロジェクトを開きます。
2. [パイプライン プロジェクト] ページから、ファイルベースのナレッジ マートを作成できます。以下のいずれかを行います:
* [新規作成] > [ファイルベースのナレッジ マート] をクリックします。
* データ タスク > [ファイルベースのナレッジ マート] の the アクション アイコン icon をクリックします。
設定ウィンドウが開きます。
3. 名前を入力します。
4. 説明を入力してください。これはオプションです。
5. [ソース接続] を作成または選択します。
6. [ベクターの保存先] ドロップダウン リストから、ドキュメントを保存する場所を選択します。プロジェクトと一緒にドキュメントを保存するには、 [データ プロジェクト プラットフォーム] を選択します。
7. [外部ベクター データベース] を選択した場合は、 [ベクター データベース接続] を作成または選択します。ドキュメントとベクターは、このベクター データベースに保存されます。
8. [LLM 接続] を作成または選択します。セマンティック検索を使用するには、この接続が必要です。
9. [作成] をクリックします。
10. ナレッジ マートが作成されたら、ドキュメントを追加します。
## ファイルの追加
情報メモドキュメントにはテキストのみが書き込まれます。図や画像からのテキストは抽出されません。
1. [データ タスク] ページの [フォルダー] タブで、フォルダーを選択するか、 [フォルダーを選択] をクリックして新しいフォルダーを選択します。
2. フォルダーを参照し、フォルダーのチェックボックスを選択します。
フォルダー内のすべてのファイルは、フォルダーに追加された時期に関係なく、サポートされている形式のいずれかであれば読み取られます。
インデックスに既に存在するファイルをフォルダーから削除しても、データはインデックスに残ります。インデックスからデータを削除するには、同じファイルを使用しますが、中身は空です。
フォルダー内のファイルの一覧を表示するには、フォルダーを右クリックします。
3. [保存] をクリックして、 [フォルダーを選択] ウィンドウを閉じます。
4. チャンク サイズやチャンクのオーバーラップを編集するには、 [設定] > [実行時間] をクリックします。
5. インデックス名を編集するには、 [設定] > [ベクター データベース設定] をクリックします。
詳細については、「[インデックス名](https://help.qlik.com/ja-JP/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/KnowledgeMart/Creating-file-based-knowledge-mart.htm#Index)」を参照してください。
6. 右側の the アクション アイコン icon > [準備] をクリックします。
7. 準備が完了したら、 [実行] をクリックします。ドキュメントは埋め込まれ、転送されます。
[実行] ボタンがアクティブになると転送が完了します。
8. 最初のフル ロードの場合は、各ファイルのステータスを確認します。
1. メニューで [モニター] を選択します。
2. ページの下部にある [フルロード ステータス] を選択します。
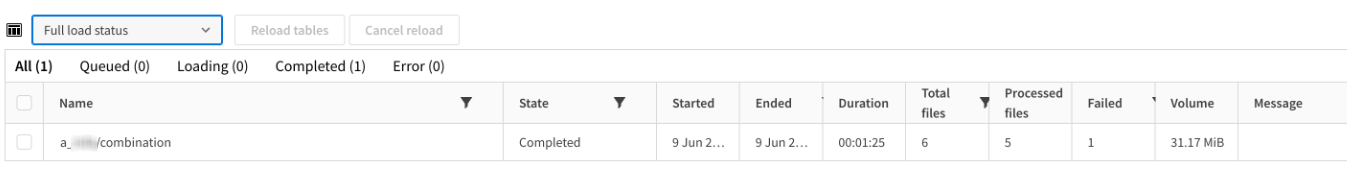
3. 一部のファイルが失敗した場合、すべてを再実行する前に、エラーを修正するかファイルを削除します。ファイルをエラーのままにしておくと、次回の実行は失敗します。
情報メモすべてのファイルをリロードすると、追加コストが発生する場合があります。
ファイルが正しい場合は、データについて質問できます。詳細については、「[テスト アシスタントの使用](https://help.qlik.com/ja-JP/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/KnowledgeMart/Test-Assistant.htm)」を参照してください。
## フル ロードと変更データキャプチャ (CDC)
フルロードと CDC がサポートされています。
フル ロード: ドキュメント インスタンスごとにドキュメントが生成され、ターゲットに送信されます。
CDC: 変更後にドキュメントが再生成されます。
ファイルが変更または追加されると、このファイルからドキュメントが読み取られます。ファイルは、チャンク サイズとオーバーラップに応じてチャンクのドキュメントに分割されます。
最初のフル ロードの場合は、各ファイルのステータスを確認します。
1. メニューで [モニター] を選択します。
2. ページの下部にある [フルロード ステータス] を選択します。

3. 一部のファイルが失敗した場合、すべてを再実行する前に、エラーを修正するかファイルを削除します。ファイルをエラーのままにしておくと、次回の実行は失敗します。
情報メモすべてのファイルをリロードすると、追加コストが発生する場合があります。
## 入力データの更新
入力データを更新したら、データ タスクを実行して変更をベクター データベースまたはデータ プラットフォームに転送する必要があります。
古いチャンクが削除され、新しいチャンクが挿入されるため、項目 `hdr__operation` は更新操作ではなく挿入操作に対応します。詳細については、「[クラウド データ ウェアハウスのデータセット アーキテクチャ](https://help.qlik.com/ja-JP/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Storage/dataset-tables.htm)」を参照してください。
## インデックス名
各ナレッジ マートには、セマンティック検索に使用されるインデックス名があります。
同じインデックスに書き込むようにタスクを構成する場合は、タスクに対して同じ LLM パラメーターを構成する必要があります。
ドキュメントを同じインデックスに配置する場合は、同じインデックス名を持つ必要があります。
インデックス名を編集するには、次を実行します。
1. [データ タスク] ページで、 [設定] をクリックします。
2. [ベクター データベース設定] タブを選択します。
3. [インデックス名] を編集します。
4. OKをクリックします。
インデックス名を編集した後、タスクを準備する必要があります。準備しないと、次回の実行時に変更が適用されません。
## タスク情報の表示
メニュー バーで the 情報 icon をクリックして、次のようなタスク情報を表示します。
* 所有者
* スペース
* データ プラットフォーム
* プロジェクトID
* データ タスク実行 ID
## 設定
ナレッジ マートの設定を表示および編集できます。
[データ タスク] ページから、the More Horizontal icon > [設定] をクリックします。
情報メモ設定はストレージ (Databricks、Snowflake など) に応じて異なるため、次の表では常に使用できる設定について説明します。それ以外の設定を使用できる場合もあります。
この表では、 [接続接続] タブの設定について説明します。
| 設定 | 説明 |
| --- | --- |
| ソース接続 | ソース接続。 |
| ベクターの保存先 | ドロップダウン リストから、次を選択します。
- 外部ベクター データベース
- データ プロジェクト プラットフォーム
|
| ベクター データベース接続
この設定は、 [ベクターの保存先] で [外部ベクターデータベース] を選択した場合に使用できます。 | ベクター データベース接続。
詳細については、「[ベクター データベースへの接続](https://help.qlik.com/ja-JP/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Landing/connecting-vector-databases.htm)」を参照してください。 |
| LLM 接続 | LLM 接続。
詳細については、「[LLM 接続への接続](https://help.qlik.com/ja-JP/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Landing/connecting-llm-connections.htm)」を参照してください。
Databricks を LLM 接続として使用する場合は、ナレッジ マートの作成時に [Embedding model serving endpoint] (埋め込みモデル提供エンドポイント) と [Completion model serving endpoint] (完了モデル提供エンドポイント) を設定します。詳細については、「[Databricks のドキュメンテーション](https://docs.databricks.com/aws/en/machine-learning/model-serving/create-foundation-model-endpoints#create-an-external-model-serving-endpoint)」を参照してください。 |
この表では、 [プラットフォーム設定プラットフォーム設定] タブの設定について説明します。
| 設定 | 説明 |
| --- | --- |
| データ タスクのスキーマ | データ タスクのスキーマの名前です。 |
| 内部スキーマ | 内部スキーマの名前です。 |
| すべてのテーブルとビューのプレフィックス | 複数のデータ タスク間の競合を解決するためのプレフィックスです。 |
この表では、 [ベクター データベース設定ベクター データベース設定] タブの設定について説明します。
| 設定 | 説明 |
| --- | --- |
| インデックス スキーマ
この設定は、 [ベクターの保存先] に [外部ベクターデータベース] を選択した場合は使用できません。 | インデックス スキーマの名前。 |
| インデックス名 | インデックスの名前。 |
| インデックスがすでに存在する場合 | 複数のタスクが同じインデックスに書き込んでいる場合、インデックスを削除する必要があるかどうかを選択します。
- 既存のインデックスを使用: インデックスは削除されません。
- インデックスをドロップして作成: インデックスは削除されます。
|
| Databricks ベクター検索エンドポイント | Databricks で作成されたベクター検索エンドポイントの名前。詳細については、「[ナレッジ マートの Databricks を構成する](https://help.qlik.com/ja-JP/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/KnowledgeMart/Creating-knowledge-marts.htm#Configur)」を参照してください。
情報メモデータ プラットフォームとして Databricks を使用するプロジェクトにのみ適用されます。 |
この表では、 [実行時間実行時間] タブの設定について説明します。
| 設定 | 説明 |
| --- | --- |
| 並列実行 | データベース接続の最大数。
1 ~ 50 の値を入力します。 |
| バルク サイズ | ナレッジ マートの場合、バルク サイズは各バルク リクエストでロードされるドキュメントの数です。
ファイルベースのナレッジ マートの場合、バルク サイズは各バルク リクエストでロードされるファイルの数です。
Snowflake および Databricks では、すべてが 1 つのクエリでロードされるため、バルク サイズは必要ありません。 |
| ロードするレコードの最大数 | 0 はすべてのレコードがロードされていることを意味します。 |
この表は、Snowflake の [表示表示] タブの設定について説明しています
| 設定 | 説明 |
| --- | --- |
| 標準ビュー | 標準ビューを使用して、クエリの結果をテーブルのように表示します。 |
| Snowflake セキュア ビュー | 基礎となるテーブルのすべてのユーザーに公開すべきではない機密データへのアクセスを制限するために作成されたビューなど、データのプライバシーまたは機密情報の保護のために指定されたビューには、Snowflake のセキュア ビューを使用します。
Snowflake セキュアビューは、標準ビューよりも実行速度が遅くなる場合があります。 |
この表では、 [テスト アシスタントテスト アシスタント] タブの設定について説明します。
| 設定 | 説明 |
| --- | --- |
| コンテキスト内のドキュメント数 | コンテキストとしてモデルに渡される関連ドキュメントの数です。 |
| プロンプト テンプレート | 含めるドキュメントをフィルタリングするために AI が従う必要のあるテンプレートを入力します。 |
| [Filter] (フィルター) | 含めるドキュメントをフィルターするための式を入力します。
フィルターはメタデータに基づいており、ファイルベースのナレッジ マートにはメタデータがないため、構成するフィルターについては慎重に検討してください。データを含めるのではなく、除外する方が適切な場合もあります。
詳細については、「[テスト アシスタントの使用](https://help.qlik.com/ja-JP/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/KnowledgeMart/Test-Assistant.htm)」を参照してください。 |
| ドキュメント検索 | ドロップダウン リストからオプションを選択します。
- 取得したコンテキストを表示: テスト アシスタントは、回答を生成するためのドキュメントを提供します。
- 取得したコンテキストを表示しない: テスト アシスタントは回答を生成しますが、ドキュメントは提供しません。
|
| 回答の生成 | ドロップダウン リストからオプションを選択します。
- 回答を生成: テスト アシスタントはドキュメントに基づいて回答を生成します。
- 回答を生成しない: テスト アシスタントはドキュメントのみで回答します。
|
## 接続またはデータ ゲートウェイの変更
ソース接続、ベクトル接続、またはベクトル データ ゲートウェイを変更した場合は、タスクを再度準備する必要があります。