# Crear un almacén de conocimiento basado en archivos
Los almacenes de conocimiento basados en archivos permiten integrar y almacenar sus datos no estructurados en una base de datos vectorial. Esto permite recuperar el contexto aumentado con funciones de búsqueda semántica para utilizarlo como contexto en aplicaciones de generación aumentada de recuperación (RAG).
Los formatos de entrada admitidos son: `PDF`, `TXT`, y Word `DOCX`.
## Requisitos
* Necesita una suscripción a Qlik Talend Cloud Enterprise.
* Compatible con las plataformas Snowflake y Databricks. Snowflake Iceberg no es compatible.
* Se requiere una pasarela de datos administrada por el cliente.
Databricks requiere la versión Pasarela de movimiento de datos de Qlik 2024.11.95 o superior.
## Instalar Pasarela de movimiento de datos de Qlik
Antes de crear un almacén de conocimiento basado en archivos debe instalar un Pasarela de movimiento de datos de Qlik específico. Para más información, vea [Configuración de Pasarela de movimiento de datos de Qlik para almacenes de conocimiento](https://help.qlik.com/es-ES/cloud-services/Subsystems/Hub/Content/Sense_Hub/Gateways/gateways-for-knowledge-mart.htm).
## Conexiones admitidas
Para obtener información sobre la compatibilidad de:
* Bases de datos vectoriales, véase [Conexión a bases de datos vectoriales](https://help.qlik.com/es-ES/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Landing/connecting-vector-databases.htm).
* Conexiones LLM, véase [Conexión a las conexiones LLM](https://help.qlik.com/es-ES/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Landing/connecting-llm-connections.htm).
* Almacenamiento de archivos, véase [Conexión con el almacenamiento de archivos](https://help.qlik.com/es-ES/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Landing/connecting-file-storage.htm).
* Almacenamiento en la nube (Amazon S3, Google Cloud Storage, Azure Data Lake Storage), consulte [Conectar con el almacenamiento en la nube](https://help.qlik.com/es-ES/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/TargetConnections/cloud-storage-connections.htm).
## Creación de los archivos
1. Haga clic en Proyectos de canalización en el menú de la izquierda y abra un proyecto.
2. Desde la página Proyecto de canalización, puede crear un almacén de conocimiento basado en archivos. Y o bien:
* Haga clic en Crear nuevo > Almacén de conocimiento basado en archivos.
* Haga clic en the Icono de acciones icon de la tarea de datos > Almacén de conocimiento basado en archivos.
Se abre la ventana de configuración.
3. Indique un nombre
4. Inserte una descripción. Esto es opcional.
5. Cree o seleccione una conexión de fuente.
6. Seleccione dónde almacenar los documentos en la lista desplegable Almacenar vectores en. Para almacenar los documentos con el proyecto, seleccione Plataforma de proyecto de datos.
7. Si ha seleccionado Base de datos vectorial externa, cree o seleccione una conexión a la base de datos vectorial. Los documentos y los vectores se almacenarán en esta base de datos vectorial.
8. Cree o seleccione una conexión LLM. Esta conexión es necesaria para utilizar la búsqueda semántica.
9. Haga clic en Crear.
10. Una vez creado el almacén de conocimiento, añada documentos.
## Agregar archivos
Nota informativaEn los documentos solo se escribe texto. No se puede extraer texto de diagramas o imágenes.
1. En la pestaña Carpetas de la página de tareas Datos, seleccione una carpeta o haga clic en Seleccionar carpetas para seleccionar una nueva.
2. Navegue hasta la carpeta, seleccione la casilla de verificación de la carpeta.
Todos los archivos de las carpetas se leerán si están en uno de los formatos admitidos, independientemente de cuándo se hayan añadido a la carpeta.
Cuando elimina de una carpeta un archivo que ya existe en el índice, los datos siguen estando en el índice. Para eliminar los datos del índice, utilice el mismo archivo, pero vacío.
Para mostrar la lista de archivos de la carpeta, haga clic en ella con el botón derecho del ratón.
3. Haga clic en Guardar para cerrar la ventana Seleccionar carpetas.
4. Para editar el tamaño de los fragmentos, el solapamiento de los fragmentos, haga clic en Configuración > Tiempo de ejecución.
5. Para editar el nombre del índice, haga clic en Configuración > Configuración de la base de datos vectorial.
Para más información, vea [Nombre del índice](https://help.qlik.com/es-ES/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/KnowledgeMart/Creating-file-based-knowledge-mart.htm#Index).
6. Haga clic en the Icono de acciones icon a la derecha > Preparar.
7. Una vez finalizada la preparación, haga clic en Ejecutar. Los documentos se están incrustando y transfiriendo.
La transferencia se completa cuando el botón Ejecutar está activo.
8. Cuando sea la primera Carga completa, verifique el estado de cada archivo:
1. Seleccione Monitor en el menú.
2. Seleccione Estado de carga completa en la parte inferior de la página.
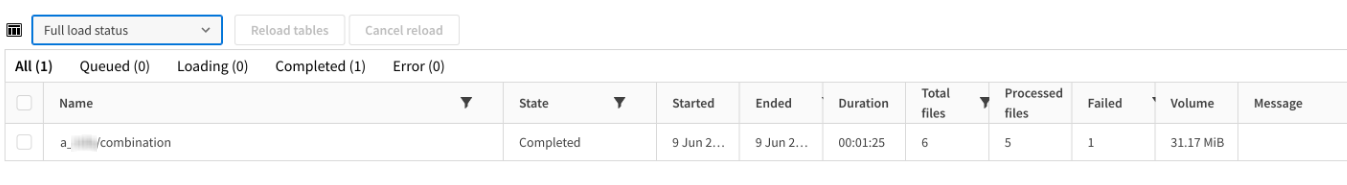
3. Cuando fallen algunos archivos y antes de volver a ejecutarlo todo, corrija los errores o elimine los archivos. Si mantiene los archivos en error, las siguientes ejecuciones fallarán.
Nota informativaRecargar todos los archivos podría acarrear costes adicionales.
Cuando sus archivos sean correctos, podrá hacer preguntas sobre sus datos. Para más información, vea [Uso del asistente de pruebas](https://help.qlik.com/es-ES/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/KnowledgeMart/Test-Assistant.htm).
## Carga completa y Captura de datos modificados (CDC)
Carga completa y CDC son compatibles.
Carga completa: Se genera un documento para cada instancia de documento y se enviará al destino.
CDC: Un documento se regenera tras cualquier cambio.
Cuando se modifica o añade un archivo, los documentos se leen de este archivo. El archivo se dividirá en documentos de trozos según el tamaño del trozo y el solapamiento.
Cuando sea la primera Carga completa, verifique el estado de cada archivo:
1. Seleccione Monitor en el menú.
2. Seleccione Estado de carga completa en la parte inferior de la página.

3. Cuando fallen algunos archivos y antes de volver a ejecutarlo todo, corrija los errores o elimine los archivos. Si mantiene los archivos en error, las siguientes ejecuciones fallarán.
Nota informativaRecargar todos los archivos podría acarrear costes adicionales.
## Actualización de los datos de entrada
Cuando actualice los datos de entrada, deberá ejecutar la tarea de datos para transferir los cambios a la base de datos de vectores o a la plataforma de datos.
Como se borran fragmentos antiguos y se insertan fragmentos nuevos, el campo `hdr__operation` corresponde a una operación de inserción, no de actualización. Para obtener más información, consulte [Arquitectura de conjuntos de datos en un almacén de datos en la nube](https://help.qlik.com/es-ES/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Storage/dataset-tables.htm)
## Nombre del índice
Cada almacén de conocimiento tiene un nombre de índice que se utiliza para la búsqueda semántica.
Cuando configure tareas para escribir en el mismo índice, deberá configurar los mismos parámetros de LLM para las tareas.
Si quiere que sus documentos estén en el mismo índice, deben tener el mismo nombre de índice.
Para editar el nombre del índice:
1. En la página Tarea de datos, haga clic en Configuración.
2. Seleccione la pestaña Configuración de la base de datos vectorial.
3. Edite el nombre del índice.
4. Haga clic en Aceptar.
Después de editar el nombre del índice, debe preparar la tarea. De lo contrario, sus cambios no se aplicarán en las siguientes ejecuciones.
## Ver la información de la tarea
Haga clic en the Información icon en la barra de menú para ver la información de la tarea, como:
* Propietario
* Espacio
* Plataforma de datos
* ID de proyecto
* ID del tiempo de ejecución de la tarea de datos
## Configuración
Puede ver y editar la configuración de un almacén de conocimiento.
En la página Tarea de datos, haga clic en the More Horizontal icon > Configuración.
Nota informativaComo los ajustes dependen del almacenamiento (Databricks, Snowflake, etc.), las tablas siguientes describen los ajustes que están siempre disponibles. Puede haber más ajustes disponibles.
Esta tabla describe los ajustes de la pestaña ConexionesConexiones.
| Configuración | Descripción |
| --- | --- |
| Conexión de fuente | La conexión de fuente. |
| Almacenar vectores en | En la lista desplegable, seleccione:
- Base de datos vectorial externa
- Plataforma de proyecto de datos
|
| Conexión a la base de datos vectorial
Este ajuste está disponible cuando se selecciona Base de datos vectorial externa para Almacenar vectores en. | La conexión a la base de datos vectorial.
Para más información, vea [Conexión a bases de datos vectoriales](https://help.qlik.com/es-ES/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Landing/connecting-vector-databases.htm). |
| Conexión a LLM | La conexión a LLM.
Para más información, vea [Conexión a las conexiones LLM](https://help.qlik.com/es-ES/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/Landing/connecting-llm-connections.htm).
Si desea utilizar Databricks como conexión LLM, configure el punto de conexión de servicio del modelo de incrustación y el punto de conexión de servicio del modelo de finalización al crear el almacén de conocimiento. Para más información, consulte la [documentación de Databricks](https://docs.databricks.com/aws/en/machine-learning/model-serving/create-foundation-model-endpoints#create-an-external-model-serving-endpoint). |
Esta tabla describe los ajustes de la pestaña Configuración de plataformaConfiguración de plataforma.
| Configuración | Descripción |
| --- | --- |
| Esquema de tarea de datos | Puede cambiar el nombre del esquema de la tarea de datos. |
| Esquema interno | El nombre del esquema interno. |
| Prefijo para todas las tablas y vistas | El prefijo para resolver conflictos entre varias tareas de datos. |
Esta tabla describe los ajustes de la pestaña Configuración de base de datos vectorialConfiguración de base de datos vectorial.
| Configuración | Descripción |
| --- | --- |
| Esquema de índice
Este ajuste no está disponible cuando se selecciona Base de datos vectorial externa para Almacenar vectores en. | El nombre del esquema del índice. |
| Nombre del índice | El nombre del índice. |
| Si el índice ya existe | Cuando varias tareas escriben en el mismo índice, seleccione si el índice debe borrarse o no:
- Utiliza el índice existente: El índice no se borra.
- Eliminar y crear el índice: El índice se elimina.
|
| Punto de conexión para la búsqueda de vectores en Databricks | El nombre del punto de conexión de búsqueda vectorial creado en Databricks. Para más información, vea [Configuración de Databricks para almacenes de conocimiento](https://help.qlik.com/es-ES/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/KnowledgeMart/Creating-knowledge-marts.htm#Configur).
Nota informativaSolo aplicable a proyectos que utilizan Databricks como plataforma de datos. |
Esta tabla describe los ajustes de la pestaña Tiempo de ejecuciónTiempo de ejecución.
| Configuración | Descripción |
| --- | --- |
| Ejecución en paralelo | El número máximo de conexiones de base de datos.
Introduzca un valor de 1 a 50. |
| Tamaño en masa | Para los almacenes de conocimiento, el tamaño del lote es el número de documentos cargados en cada solicitud de lote.
Para los almacenes de conocimiento basados en archivos, el tamaño del lote es el número de documentos cargados en cada solicitud de lote.
En Snowflake y Databricks, el tamaño del lote no es necesario, ya que todo se carga en una sola consulta. |
| Número máximo de registros que cargar | 0 significa que se cargan todos los registros. |
Esta tabla describe los ajustes de la pestaña VistasVistas para Snowflake
| Configuración | Descripción |
| --- | --- |
| Vistas estándar | Utilice las vistas estándar para mostrar los resultados de una consulta como si se tratara de una tabla. |
| Vistas seguras de Snowflake | Utilice las vistas seguras de Snowflake para aquellas vistas que precisen protección de la privacidad de datos o de la información sensible, como las vistas creadas para limitar el acceso a datos sensibles que no deban estar expuestos a todos los usuarios de las tablas.
Las vistas seguras de Snowflake pueden ejecutarse más lentamente que las vistas Estándar. |
Esta tabla describe los ajustes de la pestaña Asistente de pruebasAsistente de pruebas.
| Configuración | Descripción |
| --- | --- |
| Número de documentos en contexto | El número de documentos relevantes que se transferirán al modelo como contexto. |
| Plantilla de solicitud | Introduzca la plantilla que debe seguir la IA para filtrar los documentos que deben incluirse. |
| Filtrar | Introduzca la expresión para filtrar los documentos que deben incluirse.
Como el filtro se basa en los metadatos y los almacenes de conocimiento basados en archivos no tienen metadatos, piense detenidamente en el filtro que está configurando. Podría ser más pertinente excluir los datos en lugar de incluirlos.
Para más información, vea [Uso del asistente de pruebas](https://help.qlik.com/es-ES/cloud-services/Subsystems/Hub/Content/Sense_Hub/DataIntegration/KnowledgeMart/Test-Assistant.htm). |
| Recuperación de documentos | Seleccione la opción en la lista desplegable:
- Mostrar el contexto recuperado: El asistente de pruebas proporciona los documentos a partir de los cuales genera la respuesta.
- No mostrar el contexto recuperado: El asistente de pruebas genera una respuesta, pero no proporciona los documentos.
|
| Generación de respuestas | Seleccione la opción en la lista desplegable:
- Generar respuestas: El asistente de pruebas genera una respuesta basada en los documentos.
- No generar respuestas: El asistente de pruebas responde solo con documentos.
|
## Modificar las conexiones o la pasarela de datos
Si cambia la conexión de origen, la conexión de vector o la pasarela de datos de vector, debe preparar la tarea de nuevo.